1 引言
多维标度分析 (Multidimensional Scaling, MDS) 是一种经典统计方法, 用于将高维数据映射到低维空间, 以可视化数据点之间的相似性或距离关系. 其核心在于尽可能保留原始数据中的距离信息, 从而在二维或三维空间中直观地呈现数据结构. MDS 广泛应用于心理学、市场研究、遗传学等多个领域, 尤其在复杂数据的降维和可视化过程中发挥着关键作用, 帮助研究人员发现潜在的模式和群体. 常见的 MDS 包括经典 (度量) MDS 和非度量 MDS, 具体内容详见近年的专著[1 ,2 ] . 本文主要研究对称 MDS 中的个体差异标度模型 (Individual Differences Scaling, INDSCAL), 该模型针对多个对称数据矩阵进行同步 MDS, 能够更有效地捕捉不同个体之间的尺度差异.
INDSCAL 模型最早由 Carroll 和 Chang[3 ] 提出, 其模型几何解释见文献[4 ]. 在 MDS 的基础上, INDSCAL 模型通过对 $m$ $n$ $X_i$ $n$
(1.1) $\begin{equation} X_i = QD_iQ^T + E_i, \end{equation}$
其中 $Q$ $n \times p$ $p$ $D_i$ $i$ $p$ $E_i$ $Q$ ${D_i}$ $p \ll n$ .
INDSCAL 模型求解问题旨在寻找满足上述约束条件的矩阵集$(Q, D_1, \cdots, D_m)$ $m$ $n \times n$ $X_i (i = 1, \cdots, m)$ [2 ,5 ,6 ]
(1.2) $\begin{equation}\label{1.2} f(Q, D_1, \cdots, D_m) = \frac{1}{2}\sum_{i=1}^{m} \| X_i - QD_iQ^T \|^2, \end{equation} $
其中 $\|\cdot\|$ $D_i$ $m$ $D_i$ [3 ] 提出了基于交替最小二乘法 (Alternating Least Squares, ALS) 的标量算法 CANDECOMP 用于求解原始 INDSCAL 模型. 然而, 即使在 $X_i$ $D_i$ [7 ] . 注意到 (1.2) 式中关于 $Q$ $Q$ $D_i$ $Q$ [2 ,5 ,6 ] 考虑了具有非负显著性权重的一类正交性 INDSCAL 问题 (O-INDSCAL), 即在$Q^T Q = I_p$ $D_i$ [2 ,5 ,6 ]
(1.3) $\begin{equation}\label{problem} \begin{aligned} \min & \quad f(Q, D_1, \cdots, D_m) = \frac{1}{2}\sum_{i=1}^{m}\| X_i - QD_iQ^T \|^2 \\ \text{s. t.} & \quad (Q, D_1, \cdots, D_m) \in \mathcal{O}(n, p) \times \Omega_{+}(p)^m, \end{aligned} \end{equation} $
其中$\mathcal{O}(n, p) := \{ Q \in \mathbb{R}^{n \times p} \mid Q^T Q = I_p \}$ $n \times p$ $\Omega_{+}(p)^m := \underbrace{\Omega_{+}(p) \times \cdots \times \Omega_{+}(p)}_{m}$ $\Omega_{+}(p)$ $p$
由于 O-INDSCAL 模型本身的复杂性且变量 $Q$ $D_i$ [5 ,6 ] 将其转化为一类约束可行集下的梯度动力系统, 并设计了基于连续时间的投影梯度流求解算法. 该方法具有全局收敛性且算法易于实现, 同时在多维数据分析中其它矩阵优化模型求解上可推广性强[8 11] . 但在处理大规模问题时, 算法效率可能受限. Tendeiro[12 ] 从优化角度研究问题 (1.3) 的一阶和二阶最优化条件. 针对问题 (1.3), Takane[13 ] 给出了近似 ALS 迭代方案, 同时为克服 ALS 方法生成序列收敛较慢的缺点, 将向量序列加速中的极小多项式外推加速 (MPE) 方案应用于该矩阵序列. 数值实验表明, 在数据规模较小的情况下加速效果明显. 文献[14 ] 进一步将向量序列加速中的降秩外推加速 (RRE) 和修正极小多项式外推加速 (MMPE) 以及 Anderson 加速应用于求解问题 (1.3). 2021 年 Trendafilov 和 Gallo[2 ] 从矩阵流形角度系统总结了 MDS 中的若干经典模型, 同时针对 O-INDSCAL 模型给出了基于黎曼优化工具箱 Manopt 的算法框架.
本文在文献 [13 ,14 ] 基础上, 进一步考虑将向量序列加速中的经典[15 20] 应用于求解 O-INDSCAL 模型问题 (1.3). 值得说明的是, 文献[13 ,14 ]采用的向量序列多项式外推加速算法和 Anderson 加速应用于求解问题 (1.3) 时, 因所涉及的原始序列为矩阵序列, 通常需要用到矩阵拉直和反拉直算子, 即先通过拉直算子将矩阵序列转化为向量序列, 执行向量序列加速, 再通过反拉直算子得到矩阵外推加速迭代更新点. 另一方面, 执行向量序列多项式外推加速算法或 Anderson 加速算法时通常需要涉及矩阵分解求解相应子问题, 如执行 MPE, RRE 或 Anderson 加速时,需通过 QR 分解求解相应最小二乘问题, 执行 MMPE 时需用到列选主元的 LU 分解求解相应最小二乘问题. 与多项式外推加速算法或 Anderson 加速算法相比, $\varepsilon$ - 加速算法的优势在于不需要涉及到矩阵分解求解相应子问题, 同时拓扑 $\varepsilon$ - 算法与简化版拓扑 $\varepsilon$ - 算法可直接适用于矩阵序列或张量序列的收敛加速. $\varepsilon$ - 加速算法, 尤其是简化版拓扑 $\varepsilon$ - 算法, 由于其实现的简易性逐渐得到了数值分析领域研究学者的广泛关注[21 26], 同时在实际问题中数值表现优异, 如图像处理和图像复原[27 ] , 矩阵完全化问题[28 ] 和多线性 PageRank 计算[29 ] 等. 本文将文献[19 ,20 ] 中提出的向量 $\varepsilon$ - 算法 (VEA)、拓扑 $\varepsilon$ - 算法 (TEA) 以及简化版拓扑 $\varepsilon$ - 算法 (STEA) 应用于求解 O-INDSCAL 问题 (1.3). 首先给出求解问题 (1.3) 的不动点迭代框架, 进而利用 VEA, TEA 和 STEA 对不动点迭代原始生成矩阵序列进行收敛加速. 较充分的数值实验表明, 相较于原始不动点迭代生成矩阵序列, 结合 $\varepsilon$ - 算法的不动点迭代加速算法加速效果较为显著. 此外, 与 O-INDSCAL 问题 (1.3) 现有求解算法相比, 如基于连续时间的投影梯度流求解算法和基于黎曼优化的 Manopt 工具箱求解器, 不动点迭代加速算法在迭代效率上具有较为明显的优势.
本文余下内容组织如下: 第 2 节给出求解 O-INDSCAL 问题 (1.3) 的不动点迭代框架; 第 3 回顾 $\varepsilon$ - 算法的加速原理及其具体实施过程, 并给出求解问题 (1.3) 的结合 $\varepsilon$ - 算法的不动点迭代加速算法. 第 4 节通过数值实验验证不动点迭代加速算法的加速效果, 同时给出与模型求解已有算法的数值比较. 最后第 5 节给出结论.
2 求解 O-INDSCAL 问题 (1.3) 的不动点迭代框架
参考文献[13 ,14 ], 本节首先简要回顾求解 O-INDSCAL 问题 (1.3) 的不动点迭代框架, 更多具体细节可参考文献文献 [第 2 节]. 注意到问题 (1.3) 的目标函数$f$ $D_1, \cdots, D_m$
(2.1) $\begin{equation}\label{f_i} f_i(Q, D_i)=\frac{1}{2}\|X_i-Q{D_i}Q^T\|^2, \end{equation}$
则问题 (1.3) 的目标函数$f(Q,{D_1},\cdots,{D_m})=\sum_{i=1}^m f_i(Q, D_i)$ . 经简单计算可知, $f$ $Q$ $D_i$
(2.2) $\begin{equation}\label{oushitidu2} \nabla_Q {f}=\sum_{i=1}^m\nabla_Q {f_i}=-2\sum_{i=1}^m(X_i-QD_iQ^{{T}})QD_i \end{equation}$
(2.3) $\begin{equation}\label{oushitidu3} \nabla_{D_i} {f}=\nabla_{D_i} {f_i}=-Q^{{T}}(X_i-QD_iQ^{{T}})Q,\quad i=1, \cdots, m. \end{equation} $
给定当前迭代步$(Q^{(j)},{D}_1^{(j)},\cdots,{D}_m^{(j)})\in \mathcal{O}(n,p)\times\Omega_{+}(p)^m$
(2.4) $\begin{equation}\label{jiaoti} \left\{\begin{array}{rl} {D}_1^{(j+1)}=&\mathop{\mathrm{argmin}}\limits_{D_1} \quad f_1\left(Q^{(j)},{D}_1\right), \quad{D}_1\in \Omega_{+}(p),\\ &\vdots\\ {D}_m^{(j+1)}=&\mathop{\mathrm{argmin}}\limits_{D_m} \quad f_m\left(Q^{(j)},\ {D}_m\right),\quad {D}_m\in \Omega_{+}(p),\\ Q^{(j+1)}=&\mathop{\mathrm{argmin}}\limits_{Q}\quad f\left(Q,{{{D}_1^{(j+1)}, \cdots,{D}_m^{(j+1)}}}\right), \quad Q\in \mathcal{O}(n,p). \end{array}\right. \end{equation}$
对于 (2.4) 式中的 $D_i$
(2.5) $\begin{equation}\label{D-subproblem} \min\limits_{D_i \in \Omega_{+}(p)} f_i(Q^{(j)}, D_i) = \frac{1}{2} \big\|X_i - Q^{(j)}D_i {Q^{(j)}}^T \big\|^2. \end{equation}$
由凸约束优化的一阶最优性条件, 极值点 $D_i^{(j+1)}\in \Omega_{+}(p)$
(2.6) $\begin{equation}\label{x-subproblem-11} \langle D_i - D_i^{(j+1)}, \nabla_{D_i} f_i(Q^{(j)},\ D_i^{(j+1)}) \rangle \geq 0, \quad \forall D_i \in \Omega_{+}(p). \end{equation} $
由文献 [第 III 节] 中给出的变分不等式与投影方程关系可知, (2.6) 式等价于如下隐式投影方程
(2.7) $\begin{equation}\label{9} D_i^{(j+1)} - \mathcal{P}_{\Omega_{+}(p)}\left\{D_i^{(j+1)} - \nabla_{D_i} f_i(Q^{(j)}, D_i^{(j+1)}) \right\} = 0, \quad D_i^{(j+1)} \in \Omega_{+}(p), \end{equation} $
其中$\mathcal{P}_{\Omega_{+}(p)}(\cdot)$ $\Omega_{+}(p)$
(2.8) $\begin{equation}\label{touying0} \mathcal{P}_{\Omega_{+}(p)}(M)=\max\{0, I_p\odot M\}, \ \ \forall M\in \mathbb{R}^{p\times p}, \end{equation}$
其中$\odot$ $\max\{A,B\}$ $A,B$ $Q^{(j)}\in \mathcal{O}(n,p)$ ${Q^{(j)}}^TQ^{(j)}=I_p$ $D_i$
(2.9) $\begin{align*}\label{D} D_i^{(j+1)}=\max\left\{0,\ I_p\odot \left({Q^{(j)}}^TX_i{Q^{(j)}}\right)\right\},\ \ i=1, \cdots, m. \end{align*}$
对于 (2.4) 式中的 $Q$ $Q^TQ=I_p$
其中拉格朗日乘子$\Lambda$ $\Lambda^T=\Lambda$ $Q^TQ=I_p$
(2.10) $\begin{align*}\label{gs2} (I_n-QQ^T)\sum_{i=1}^mX_iQ{D}_i^{(j+1)}=0 \qquad Q\in \mathcal{O}(n,p). \end{align*} $
显然无法直接从 (2.10) 式中获得 $Q$ $Q$ [13 ,14 ] : (1) 利用当前迭代步$Q^{(j)}$ $G^{(j)}:=\sum_{i=1}^mX_i Q^{(j)}{D}_i^{(j+1)}$ $Q^TQ=I_p$ $(I_n-QQ^T)G^{(j)}=0$ $ Q^{(j+1)}$ . 记$G^{(j)}=U\triangle V^T$ $G^{(j)}\in \mathbb{R}^{n\times p}$ $U\in\mathbb{R}^{n\times p}$ $V\in\mathbb{R}^{p\times p}$ 31 ], 方程$(I_n-QQ^T)G^{(j)}$ $=0$ $Q^TQ=I_p$ $Q$
(2.11) $\begin{equation}\label{Q} Q^{(j+1)}=G^{(j)}\left({G^{(j)}}^TG^{(j)}\right)^{-\frac{1}{2}}=UV^T. \end{equation} $
结合迭代框架 (2.4), 子问题解析表达式(2.9) 和(2.11), 可得求解问题 (1.3) 的近似交替最小二乘算法流程如下
(2.12) $\begin{equation}\label{fix-iteration} Q^{(j+1)}=\mathcal{H}_{\mathrm{INDSCAL}}(Q^{(j)}), \end{equation}$
其中$\mathcal{H}_{\mathrm{INDSCAL}}: \mathbb{R}^{n\times p}\rightarrow \mathbb{R}^{n\times p}$ $Q^{(j)}\longrightarrow Q^{(j+1)}$
3 求解不动点迭代问题 (2.12) 的 $\varepsilon$ - 加速算法
提高迭代序列 (标量, 向量, 矩阵或张量序列等) 的收敛速度在科学与工程计算及机器学习等领域具有重要意义[32 39] , 也是当今计算数学领域的研究热点课题之一[40 43] . 对于收敛较慢的序列, 通常采用合适的加速算法加速其收敛. 通过序列变换调整其生成过程, 将原序列转变为新序列, 在特定条件下, 新序列能够更快收敛至相同的极限. 对于标量数列, 最著名的变换之一是标量 Shanks 变换[15 ] , 它可以通过 Wynn 的标量 $\varepsilon$ - 算法逐步递归实现[16 ] . Wynn[17 ] 同时扩展了该变换, 使其适用于向量序列. 但向量 $\varepsilon$ - 算法的代数理论无法直接从标量 Shanks 变换的规则中推导出来. 为弥补这一不足, Brezinski[18 ] 引入了拓扑 Shanks 变换, 并通过两种拓扑 $\varepsilon$ - 算法 (TEA1 和 TEA2) 将其推广至任意向量空间中的向量序列, 从而实现了该算法的扩展. 近年来, TEA1 和 TEA2 的规则得到了简化, 衍生出两类简化版拓扑 $\varepsilon$ - 算法 (STEA1 和 STEA2)[19 ] , 相关的软件应用见文献[20 ]. 这两种简化版拓扑 $\varepsilon$ - 算法通过减少向量的使用显著降低了存储需求, 并提高了算法的数值稳定性.
为论文完整性, 本节在文献[17 20] 的基础上, 细致阐述 $\varepsilon$ - 加速算法的理论基础, 加速原理及具体实施方案, 进而结合上一节所构建的的不动点迭代框架 (2.12), 设计求解 O-INDSCAL 问题 (1.3) 基于 $\varepsilon$ - 算法的不动点迭代加速算法.
3.1 $\varepsilon$
设$\{S_n\}$ $K$ $\mathbb{R}$ $\mathbb{C}$ ) 上的标量序列, 且$\lim\limits_{n\to\infty} S_n = S$ . 当序列收敛缓慢时, 可以通过合适的序列变换将序列$\{S_n\}$ $\{T_n\}$ $\lim\limits_{n\to\infty} T_n = S$
(3.1) $\begin{equation}\label{shizi3.1} \lim\limits_{n\to\infty} \frac{T_n - S}{S_n - S} = 0, \end{equation} $
新的序列$\{T_n\}$ $\{S_n\}$ $\varepsilon$ - 变换、Levin 变换、Shanks 变换、$\rho$ $\theta$ $\eta$ [18 ,44 ] . Shanks 变换假定序列满足如下关系式[20 ,40 ]
(3.2) $\begin{equation}\label{shizi3.2} \alpha_0 (S_n - S) + \cdots + \alpha_k (S_{n+k} - S) = 0, \quad n = 0, 1, \cdots \end{equation}$
其中系数$\alpha_i$ $n$ $\alpha_0\alpha_k\neq 0$ $\alpha_0 + \cdots + \alpha_k \neq 0$ . 假设式 (3.2) 对$\forall n$
(3.3) $\begin{equation}\label{shizi3.3} \Delta S_n \alpha_0 + \cdots + \Delta S_{n+k} \alpha_k = 0, \end{equation} $
其中一阶向前差分算子$\Delta$ $\Delta S_i = S_{i+1} - S_i$ . 为确定$k+1$ $\alpha_i$ $\alpha_0 + \cdots + \alpha_k = 1$ $k+1$
(3.4) $\begin{equation}\label{shizi3.4} \begin{cases} \alpha_0 + \cdots + \alpha_k = 1, \\ \Delta S_{n+i} \alpha_0 + \cdots + \Delta S_{n+k+i} \alpha_k = 0, \quad i = 0, \cdots, k-1. \end{cases} \end{equation} $
求解该线性系统, 可以确定系数$\alpha_i$ $S$
(3.5) $\begin{equation}\label{shizi3.5} S = \alpha_0 S_n + \alpha_1 S_{n+1} + \cdots + \alpha_k S_{n+k}. \end{equation} $
若序列$\{S_n\}$ $\alpha_i$ $S$ $n$ $k$ $\alpha_i^{(n,k)}$ $e_k(S_n)$
其中 $\alpha_i^{(n,k)}$
(3.6) $\begin{equation}\label{shizi3.6} \begin{cases} \alpha_0^{(n,k)} + \cdots + \alpha_k^{(n,k)} = 1, \\ \alpha_0^{(n,k)} \Delta S_n + \cdots + \alpha_k^{(n,k)} \Delta S_{n+k} = 0, \\ \quad \vdots \\ \alpha_0^{(n,k)} \Delta S_{n+k-1} + \cdots + \alpha_k^{(n,k)} \Delta S_{n+2k-1} = 0, \end{cases} \end{equation}$
由此序列 $\{S_n\}$ $\{e_k(S_n)\}$ $\{S_n\} \to \{e_k(S_n)\}$ $e_k(S_n)$
(3.7) $\begin{equation}\label{shizi3.7} e_k(S_n) ={\frac{\begin{vmatrix} S_n & S_{n+1} & \cdots & S_{n+k} \\ \Delta S_n & \Delta S_{n+1} & \cdots & \Delta S_{n+k} \\ \vdots & \vdots & & \vdots \\ \Delta S_{n+k-1} & \Delta S_{n+k} & \cdots & \Delta S_{n+2k-1} \end{vmatrix}}{\begin{vmatrix} 1 & 1 & \cdots & 1 \\ \Delta S_n & \Delta S_{n+1} & \cdots & \Delta S_{n+k} \\ \vdots & \vdots & & \vdots \\ \Delta S_{n+k-1} & \Delta S_{n+k} & \cdots & \Delta S_{n+2k-1} \end{vmatrix}}}, \quad k,n = 0,1,\cdots. \end{equation} $
为避免计算 (3.7) 式中的行列式, Wynn[16 ] 提出了一类只需简单递归的标量 $\varepsilon$ - 算法 (SEA) 用于实现 Shanks 变换, 其计算规则如下
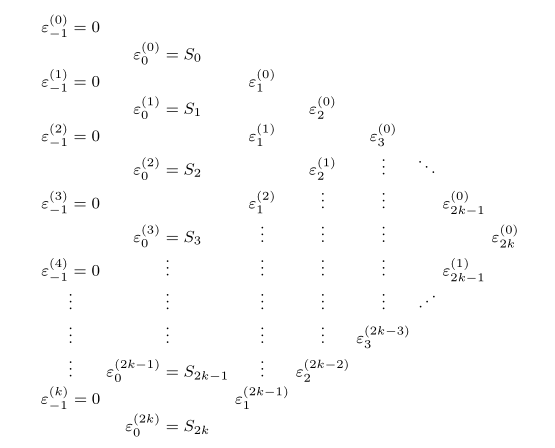
(3.8) $\begin{equation}\label{shizi3.8} \begin{cases} \varepsilon_{-1}^{(n)} = 0, \quad n = 0,1,\cdots, \\ \varepsilon_0^{(n)} = S_n, \quad n = 0,1,\cdots, \\ \varepsilon_{k+1}^{(n)} = \varepsilon_{k-1}^{(n+1)} + (\varepsilon_k^{(n+1)} - \varepsilon_k^{(n)})^{-1}, \quad k,n = 0,1,\cdots. \end{cases} \end{equation} $
(3.8) 式中 $\varepsilon_k^{(n)}$ 表1 所示, 称为$\varepsilon$ $\{\varepsilon_k^{(n)}\}_{n=0}^{\infty}$ $k$ $\{\varepsilon_k^{(n)}\}_{k=0}^{\infty}$ $n$ [16 ] 同时给出了如下重要结果建立了标量 Shanks 变换与标量 $\varepsilon$ - 算法之间的联系
(3.9) $\begin{equation}\label{shizi3.9} \varepsilon_{2k}^{(n)} = e_k(S_n), \quad \varepsilon_{2k+1}^{(n)} = \frac{1}{e_k(\Delta S_n)}. \end{equation} $
通过引入向量空间 $E$
(3.10) $\begin{equation}\label{shizi3.10} z^{-1} = \frac{z}{(z, z)}, \quad \forall z \in E, \end{equation} $
其中$(\cdot, \cdot)$ $E$ [17 ] 进一步将标量$\varepsilon$ - 算法 " 矢量化", 推广应用到向量空间$E=\mathbb{R}^m$ $\{S_n\}$ $\varepsilon$ - 算法 (VEA), 其递归规则同(3.8) 式. 然而 Shanks 变换无法直接推广到向量空间. 为了克服这一局限, Brezinski[18 ] 通过引入向量空间的代数对偶空间$E^*$ $\mathbf{y} \in E^*$ $\langle\cdot, \cdot\rangle$
其中系数$\alpha_i^{(n,k)}$
(3.11) $\begin{equation}\label{shizi3.11} \begin{cases} \alpha_0^{(n,k)} + \cdots + \alpha_k^{(n,k)} = 1, \\ \alpha_0^{(n,k)} \langle \mathbf{y}, \Delta S_n \rangle + \cdots + \alpha_k^{(n,k)} \langle \mathbf{y}, \Delta S_{n+k} \rangle = 0, \\ \quad \vdots \\ \alpha_0^{(n,k)} \langle \mathbf{y}, \Delta S_{n+k-1} \rangle + \cdots + \alpha_k^{(n,k)} \langle \mathbf{y}, \Delta S_{n+2k-1} \rangle = 0. \end{cases} \end{equation}$
同样与标量 Shanks 变换类似, $\widehat{e}_k(S_n)$
(3.12) $\begin{equation}\label{shizi3.12} \widehat{e}_k(S_n) ={\frac{\begin{vmatrix} S_n & S_{n+1} & \cdots & S_{n+k} \\ \langle \mathbf{y}, \Delta S_n \rangle & \langle \mathbf{y}, \Delta S_{n+1} \rangle & \cdots & \langle \mathbf{y}, \Delta S_{n+k} \rangle \\ \vdots & \vdots & & \vdots \\ \langle \mathbf{y}, \Delta S_{n+k-1} \rangle & \langle \mathbf{y}, \Delta S_{n+k} \rangle & \cdots & \langle \mathbf{y}, \Delta S_{n+2k-1} \rangle \end{vmatrix}}{\begin{vmatrix} 1 & 1 & \cdots & 1 \\ \langle \mathbf{y}, \Delta S_n \rangle & \langle \mathbf{y}, \Delta S_{n+1} \rangle & \cdots & \langle \mathbf{y}, \Delta S_{n+k} \rangle \\ \vdots & \vdots & & \vdots \\ \langle \mathbf{y}, \Delta S_{n+k-1} \rangle & \langle \mathbf{y}, \Delta S_{n+k} \rangle & \cdots & \langle \mathbf{y}, \Delta S_{n+2k-1} \rangle \end{vmatrix}}}, \quad k, n = 0,1,\cdots, \end{equation} $
其中分子表示第一行为 $E$
其中系数$\alpha_i^{(n,k)}$ $\widetilde{e}_k(S_n)$ $S_{n+k}, \cdots, S_{n+2k}$ . 注意代数对偶空间$E^*$ $\mathbf{y}$
通过引入新的向量逆, Brezinski[20 ] 给出了计算拓扑Shanks 变换 $\widehat{e}_k(S_n)$ $\widetilde{e}_k(S_n)$ $\varepsilon$ $\varepsilon$ $\varepsilon$ $\{u, \mathbf{y}\} \in E \times E^*$
(3.13) $\begin{equation}\label{shizi3.13} u^{-1} = \frac{\mathbf{y}}{\langle \mathbf{y}, u \rangle} \in E^*, \quad \mathbf{y}^{-1} = \frac{u}{\langle \mathbf{y}, u \rangle} \in E. \end{equation} $
计算 $\widehat{e}_k(S_n)$ $\varepsilon$ - 算法 (TEA1) 的递归规则如下
(3.14) $\begin{equation}\label{shizi3.14} \begin{cases} \widehat{\varepsilon}^{(n)}_{-1} = 0 \in E^*, & n = 0, 1, \cdots, \\ \widehat{\varepsilon}^{(n)}_0 = S_n \in E, & n = 0, 1, \cdots, \\ \widehat{\varepsilon}^{(n)}_{2k+1} = \widehat{\varepsilon}^{(n+1)}_{2k-1} + (\widehat{\varepsilon}^{(n+1)}_{2k} - \widehat{\varepsilon}^{(n)}_{2k})^{-1}\in E^*, & k, n = 0, 1, \cdots, \\ \widehat{\varepsilon}^{(n)}_{2k+2} = \widehat{\varepsilon}^{(n+1)}_{2k} + (\widehat{\varepsilon}^{(n+1)}_{2k+1} - \widehat{\varepsilon}^{(n)}_{2k+1})^{-1}\in E, & k, n = 0, 1, \cdots. \end{cases} \end{equation} $
由于 (3.13) 式中位于$E$ $E^*$ $\widehat{\varepsilon}^{(n)}_{2k+1} = \widehat{\varepsilon}^{(n+1)}_{2k-1} + (\widehat{\varepsilon}^{(n+1)}_{2k} - \widehat{\varepsilon}^{(n)}_{2k})^{-1}$ $\widehat{\varepsilon}^{(n+1)}_{2k} - \widehat{\varepsilon}^{(n)}_{2k}\in E^*$ $(\widehat{\varepsilon}^{(n+1)}_{2k} - \widehat{\varepsilon}^{(n)}_{2k}, \mathbf{y})\ \in E \times E^*$ $\mathbf{y} \in E^*$
同样对应于 (3.8), TEA1 中偶数下标序列$\widehat{\varepsilon}^{(n)}_{2k+2} = \widehat{\varepsilon}^{(n+1)}_{2k} + (\widehat{\varepsilon}^{(n+1)}_{2k+1} - \widehat{\varepsilon}^{(n)}_{2k+1})^{-1}$ $\widehat{\varepsilon}^{(n+1)}_{2k+1} - \widehat{\varepsilon}^{(n)}_{2k+1}\in E$ $(\widehat{\varepsilon}^{(n+1)}_{2k} -\widehat{\varepsilon}^{(n)}_{2k}, \widehat{\varepsilon}^{(n+1)}_{2k+1} - \widehat{\varepsilon}^{(n)}_{2k+1}) \in E \times E^*$
计算 $\widetilde{e}_k(S_n)$ $\varepsilon$ - 算法 (TEA2) 的递归规则如下
(3.15) $\begin{equation} \begin{cases} \widetilde{\varepsilon}^{(n)}_{-1} = 0 \in E^*, & n = 0, 1, \cdots, \\ \widetilde{\varepsilon}^{(n)}_0 = S_n \in E, & n = 0, 1, \cdots, \\ \widetilde{\varepsilon}^{(n)}_{2k+1} = \widetilde{\varepsilon}^{(n+1)}_{2k-1} + (\widetilde{\varepsilon}^{(n+1)}_{2k} - \widetilde{\varepsilon}^{(n)}_{2k})^{-1}\in E^*, & k, n = 0, 1, \cdots, \\ \widetilde{\varepsilon}^{(n)}_{2k+2} = \widetilde{\varepsilon}^{(n+1)}_{2k} + (\widetilde{\varepsilon}^{(n+1)}_{2k+1} - \widetilde{\varepsilon}^{(n)}_{2k+1})^{-1}\in E, & k, n = 0, 1, \cdots. \end{cases} \end{equation}$
TEA2 中奇数下标序列的计算同TEA1 中$\widehat{\varepsilon}^{(n)}_{2k+1}$ . 对于偶数下标序列, 对应于(3.8) 式有$\widetilde{\varepsilon}^{(n)}_{2k+2} = \widetilde{\varepsilon}^{(n+1)}_{2k} + (\widetilde{\varepsilon}^{(n+1)}_{2k+1} - \widetilde{\varepsilon}^{(n)}_{2k+1})^{-1}$ $\widetilde{\varepsilon}^{(n+1)}_{2k+1} - \widetilde{\varepsilon}^{(n)}_{2k+1}\in E$ $(\widetilde{\varepsilon}^{(n+2)}_{2k} - \widetilde{\varepsilon}^{(n+1)}_{2k}, \widetilde{\varepsilon}^{(n+1)}_{2k+1} - \widetilde{\varepsilon}^{(n)}_{2k+1}) \in E \times E^*$
Brezinski[20 ] 同时给出了如下重要结果建立了拓扑 Shanks 变换与拓扑 $\varepsilon$ - 算法之间的联系. 对于第一类拓扑 Shanks 变换 $\widehat{e}_k(S_n)$ $\widehat{\varepsilon}^{(n)}_k$
(3.16) $\begin{equation}\label{shizi3.16} \begin{aligned} \widehat{\varepsilon}^{(n)}_{2k} &= \widehat{e}_k(S_n), & \langle \mathbf{y}, \widehat{\varepsilon}^{(n)}_{2k} \rangle &= e_k(\langle \mathbf{y}, S_n \rangle), \\ \widehat{\varepsilon}^{(n)}_{2k+1} &= \frac{\mathbf{y}}{\langle \mathbf{y}, \widehat{e}_k(\Delta S_n) \rangle}, & \widehat{\varepsilon}^{(n)}_{2k+1} &= \frac{\mathbf{y}}{e_k(\langle \mathbf{y}, \Delta S_n \rangle)}, \quad k, n = 0, 1, \cdots. \end{aligned} \end{equation} $
对于第二类拓扑 Shanks 变换 $\widetilde{e}_k(S_n)$ $\widetilde{\varepsilon}^{(n)}_k$
(3.17) $\begin{equation}\label{shizi3.17} \begin{aligned} \widetilde{\varepsilon}^{(n)}_{2k} &= \widetilde{e}_k(S_n), & \langle \mathbf{y}, \widetilde{\varepsilon}^{(n)}_{2k} \rangle &= e_k(\langle \mathbf{y}, S_n \rangle), \\ \widetilde{\varepsilon}^{(n)}_{2k+1} &= \frac{\mathbf{y}}{\langle \mathbf{y}, \widetilde{e}_k(\Delta S_n) \rangle}, & \widetilde{\varepsilon}^{(n)}_{2k+1} &= \frac{\mathbf{y}}{e_k(\langle \mathbf{y}, \Delta S_n \rangle)}, \quad k, n = 0, 1, \cdots. \end{aligned} \end{equation} $
注意 (3.16) 和 (3.17) 式中 $e_k(\langle \mathbf{y}, S_n \rangle)$ $\{\langle \mathbf{y}, S_n \rangle\}$
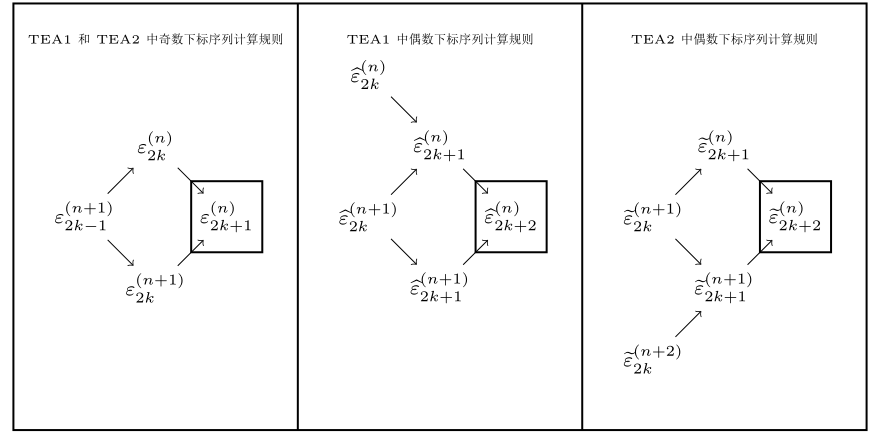
TEA1 和 TEA2 中奇数下标和偶数下标序列的计算规则如表 2 所示. 对于奇数下标, 两类拓扑 $\varepsilon$ - 算法的计算规则完全相同, 且与 SEA 的计算规则保持一致, 即计算 $\varepsilon^{(n)}_{2k+1}$ $\varepsilon^{(n+1)}_{2k-1}$ $\varepsilon^{(n)}_{2k}$ $\varepsilon^{(n+1)}_{2k}$ . 但对于偶数下标序列, 除了菱形结构数表顶点位置处的三个元素外, TEA1 和 TEA2 均需额外增加一项的信息. 同时两种算法在递归过程中都必须同时存储位于 $E$ $E^*$
为了优化两类拓扑$\varepsilon$ - 算法的计算规则, Brezinski[20 ] 针对 TEA1 和 TEA2 分别提出了简化版拓扑 $\varepsilon$ - 算法 (STEA1 和 STEA2), 其通过将 TEA 和 SEA 相结合产生更高效的新算法. 在递归过程中, 两类简化拓扑 $\varepsilon$ - 算法不仅可以大幅度减少对偶积运算, 即在递归过程中代数对偶空间 $E^*$ $\mathbf{y}$ $E$ $\{S_n\}$ $\langle \mathbf{y}, S_n \rangle$
考虑标量序列 $\{\langle \mathbf{y}, S_n \rangle\}$ $E^*$ $\mathbf{y}$ $\{S_n\}$ $\varepsilon$ - 算法 SEA, 由标量 Shanks 变换与 SEA 的关系 (3.9) 有
(3.18) $\begin{equation}\label{shizi3.18} \varepsilon^{(n)}_{2k} = e_k(\langle \mathbf{y}, S_n \rangle), \quad \varepsilon^{(n)}_{2k+1} = \frac{1}{e_k(\langle \mathbf{y}, \Delta S_n \rangle)}. \end{equation} $
对于 TEA1 的递归规则 (3.14) 中偶数下标序列分母中的$\widehat{\varepsilon}^{(n+1)}_{2k+1} - \widehat{\varepsilon}^{(n)}_{2k+1}$ $\widehat{e}_k(S_n)$
(3.19) $\begin{equation} \widehat{\varepsilon}^{(n+1)}_{2k+1} -\widehat{\varepsilon}^{(n)}_{2k+1} = \frac{\mathbf{y}}{e_k(\langle \mathbf{y}, \Delta {S}_{n+1} \rangle)}- \frac{\mathbf{y}}{{e_k}(\langle \mathbf{y}, \Delta {S}_{n} \rangle)} = \mathbf{y} (\varepsilon^{(n+1)}_{2k+1} - \varepsilon^{(n)}_{2k+1}). \end{equation}$
由此可得 TEA1 中偶数下标序列递归规则可转换为
进一步结合(3.16) 和(3.18) 式, 上式分母中$\langle \mathbf{y}, \widehat{\varepsilon}^{(n+1)}_{2k} - \widehat{\varepsilon}^{(n)}_{2k} \rangle$ $\varepsilon$ - 算法生成, 即
(3.20) $\begin{equation}\label{shizi3.20} \text{STEA1-1}\quad \widehat{\varepsilon}^{(n)}_{2k+2} = \widehat{\varepsilon}^{(n+1)}_{2k} + \frac{1}{(\varepsilon^{(n+1)}_{2k+1} - \varepsilon^{(n)}_{2k+1})(\varepsilon^{(n+1)}_{2k} - \varepsilon^{(n)}_{2k})} (\widehat{\varepsilon}^{(n+1)}_{2k} - \widehat{\varepsilon}^{(n)}_{2k}), \end{equation} $
其中$\widehat{\varepsilon}^{(n)}_0 = S_n \in E, n = 0,1,\cdots$ . 结合 SEA 递归规则(3.8), 可以推导 TEA1 中偶数下标序列与(3.20) 式等价的另外三种递归公式
类似地, 结合 SEA 递归规则 (3.8), 第二类拓扑 Shanks 变换 $\widetilde{e}_k(S_n)$
其中$\widetilde{\varepsilon}^{(n)}_0 = S_n \in E,\ n = 0,1,\cdots$ .
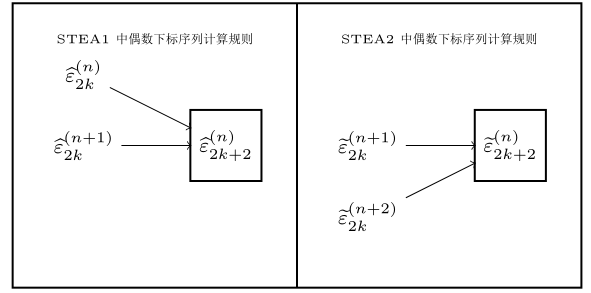
由上述计算公式可知, STEA1 和 STEA2 中偶数下标序列的递归只需用到偶数下标序列的信息, 如表 3 所示. 同时注意到, 结合 (3.16) 和 (3.17) 式中第一个等式$\widehat{\varepsilon}^{(n)}_{2k} = e_k(S_n)$ $\widetilde{\varepsilon}^{(n)}_{2k} = e_k(S_n)$ $\widehat{e}_k(S_n)$ $\widetilde{e}_k(S_n)$ $\varepsilon$ - 算法的递归过程中, 均只需存储偶数下标序列的信息, 不需涉及奇数下标序列的存储. 同时 STEA1 和 STEA2 在递归过程中减少了对偶积运算, $E^*$ $\mathbf{y}$ $E$ $\{S_n\}$ $\{\langle \mathbf{y}, S_n \rangle\}$ $\{\langle \mathbf{y}, S_n \rangle\}$ $\varepsilon$ - 算法的收敛性分析和加速理论分析可见文献[20 ].
3.2 $\varepsilon$ - 加速算法具体实施
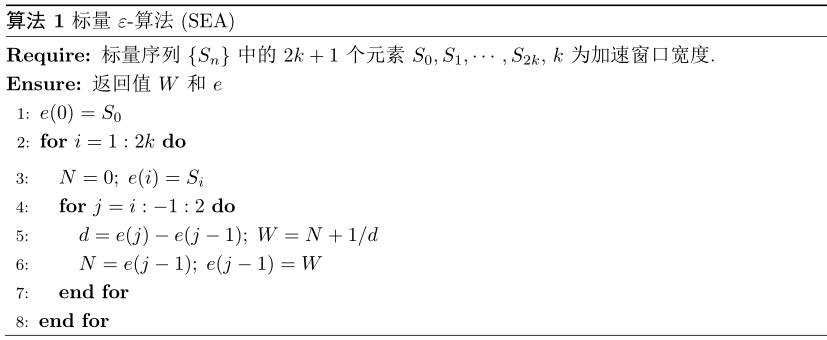
为了实现 $\varepsilon$ - 算法 (SEA, VEA, TEA 和 STEA) 并构造 $\varepsilon$ - 数表, 最直接的方法是存储所有 $k$ $n$ $\varepsilon$ - 数表的三角形部分. 然而, 这样的方法需要存储整个三角形部分的所有元素, 对于向量序列或矩阵序列而言, 可能会导致较高的存储开销. 为了避免存储整个三角形数表, 一种更高效的方法是逐步计算原始序列的每一项, 并按升序对角线的顺序计算 $\varepsilon$ - 数表[19 ,20 ] . 在生成 $\varepsilon$ - 数表的一个三角形部分并仅存储了其最后一行升序对角线后, 引入初始序列 $\{S_n\}$ $(e_i)$
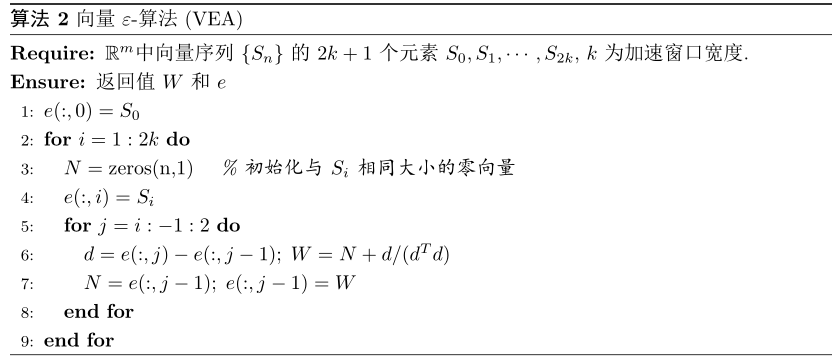
文献[20 ] 中给出了 SEA、VEA、TEA 及 STEA 的基于 MATLAB 的算法工具箱$ {\tt EPSfun}$ $k$ $2k$ $\mathbb{R}^m$ $(x, y)=x^Ty,\ \forall x, y\in \mathbb{R}^m$ .
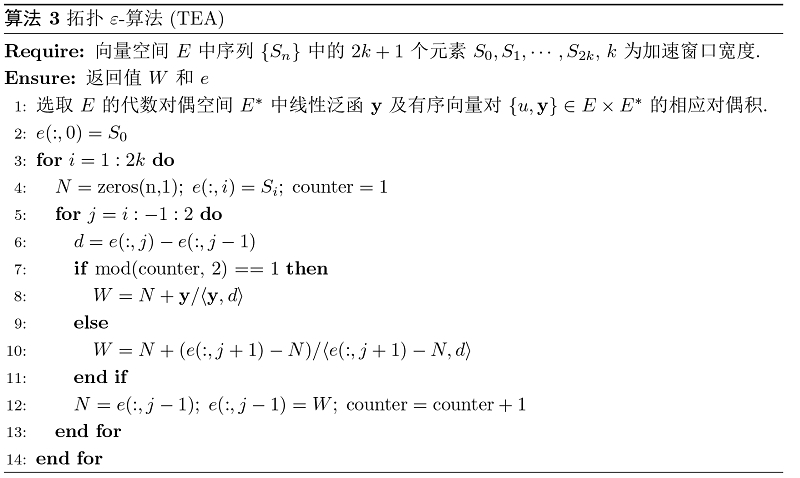
算法 3 给出了 TEA 的实施过程, 注意 TEA 中对奇数下标序列和偶数下标序列分别采用不同的规则. 具体而言, 奇数下标的计算规则与 SEA 和 VEA 相同, 而偶数下标的计算则需要引入额外的元素. 因为 $\varepsilon$ - 数表的构造过程自上而下进行, 仅需存储一条上升对角线上的元素. 对于 TEA2, 偶数下标计算中增加的元素正好是新引入的初始序列元素, 因此不需要额外的存储空间. 而对于 TEA1, 偶数下标计算所需的额外元素并不在当前对角线上, 因此 TEA1 需要额外存储前一条上升对角线上的偶数下标元素.
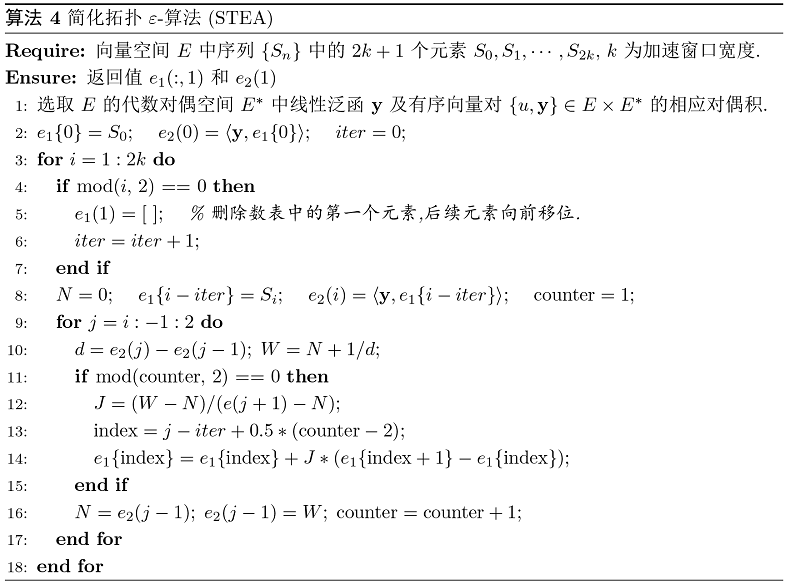
算法 4 给出了STEA 的实施过程, 注意STEA 的执行过程由标量部分和向量部分组成. 标量部分继续采用菱形结构, 而向量部分的计算规则调整为三角结构. 在标量部分, 每个新标量项是通过计算序列$\{S_n\}$ $\mathbf{y}$ $k$ 20 ] 中STEA 的标量部分首先利用 SEA 计算所需的标量值, 再通过 STEA 算法处理. 算法 4 给出了STEA2-3 的具体实施过程, 另外三种等价形式可以通过修改算法中的变量$j$
注 3.1 SEA、VEA、TEA 及 STEA 在执行过程中, 不涉及任何矩阵分解, 也不需要求解相关子问题, 这是 $\varepsilon$ - 加速算法区别于向量序列多项式外推加速 (如 MPE, MMPE 和 RRE 等) 和 Anderson 加速算法的优势所在. 关于 $E$ $E^*$ $\mathbf{y}$ 19 ,20 ]给出了常用的选取方式. 若原始序列为向量序列$\{S_n\}\subset \mathbb{R}^m$ $\{S_n\}\subset \mathbb{R}^{m\times n}$ $\mathbb{R}^m$ $\mathbb{R}^{m\times n}$
$ \bullet $ $E=\mathbb{R}^m$ $y=ones(m,1)$ $m$ $\langle \mathbf{y}, S_n\rangle=(\mathbf{y}, S_n)=y^TS_n$
$ \bullet $ $E=\mathbb{R}^{n\times n}$ $\mathbf{y}=I_n$ $\langle \mathbf{y}, S_n\rangle=\mathrm{trace}(S_n)$
$ \bullet $ $E=\mathbb{R}^{m\times n}$ $\mathbf{y}=ones(m,n)$ $\langle \mathbf{y}, S_n\rangle=\mathrm{trace}(\mathbf{y}^TS_n)$ .
3.3 $\varepsilon$-加速算法应用于求解 O-INDSCAL 问题(1.3)
考虑到不动点迭代(2.12) 生成的原始序列为矩阵序列, 同时$\mathcal{H} _{\mathrm{INDSCAL}}: \mathbb{R}^{n\times p}\rightarrow \mathbb{R}^{n\times p}$ [45 ] 采用循环的方式执行 $\varepsilon$ - 加速算法. 另一方面, 在加速算法的具体执行中, 为达到更好的加速效果, 通常采用延迟启动的方式, 即基本不动点迭代 (2.12) 先迭代若干固定次数或矩阵序列$\{(Q^ {(j)}, D_1^{(j)}, \cdots, D_m^{(j)})\}$ $\varepsilon$ - 算法的不动点迭代加速算法的具体描述见算法 5.
注 3.2 按注记选定 $E^*$ $\mathbf{y}$ $2k+1$ $S_0, S_1,\cdots, S_{2k}$ $2k+1$ $s_0, s_1, \cdots, s_{2k}$ $s_ {2k}^{(0)}$ $S_{2k}^{(0)}$ $Q^*$
注 3.3 对于算法 5 的终止标准, 结合问题 (1.3) 的一阶最优性条件[12 ] , 同时注意到$\mathcal{O}(n,p)$ $\mathbb{R} ^{n\times p}$ [46 ] 以及$\Omega_{+}(p)$
(3.21) $\begin{equation}\label{zhongzhi} \begin{array}{rl} \mathrm{Error}= &\left(\left\|\mathcal{P}_{{\mathbf{T}_{Q^{(j)}}\mathcal{O}(n,p)}}\left(\nabla_{Q} {f}\big(Q^{(j)}, D_1^{(j)}, \cdots, D_m^{(j)}\big)\right)\right\|^2\right.\\ &\hspace{0.1cm}\left.+\sum\limits_{i=1}^m\left\|\mathcal{P}_{\Omega_{+}(p)}\left(D_i^{(j)}-\nabla_{D_i}f_i\big(Q^{(j)}, D_i^{(j)}\big)\right)-D_i^{(j)}\right\|^2\right)^{\frac{1}{2}}\leq \epsilon, \end{array} \end{equation}$
其中$\epsilon$ $\mathcal{P}_{{\mathbf{T}_{Q}}\mathcal{O}(n,p)}$ $\mathcal{O}(n,p)$ $Q$ ${\mathbf{T}_{Q}\mathcal{O}(n,p)}$ 2 ,46 ], $\forall M\in \mathbb{R}^{n\times p}$
(3.22) $\begin{equation}\label{touying222} \mathcal{P}_{{\mathbf{T}_{Q}}\mathcal{O}(n,p)}(M)=M- Q\ \mathrm{sym}( {Q}^T {M}),\quad \forall Q\in \mathcal{O}(n,p), \end{equation} $
其中$\mathrm{sym}(A)$ $A$ $\mathrm{sym}(A)=(A+A^T)/2$ .
4 数值实验
本节给出数值实验说明结合 $\varepsilon$ - 算法的不动点迭代加速算法应用于求解 O-INDSCAL 问题 (1.3) 的数值效果. 首先给出结合 $\varepsilon$ - 算法的不动点迭代加速算法与原始不动点迭代的数值比较, 进而给出结合 $\varepsilon$ - 算法的不动点迭代加速算法与文献[14 ] 提出的结合向量序列多项式外推加速的不动点迭代加速算法和结合 Anderson 加速的不动点迭代加速算法的数值比较. 同时给出加速算法与问题 (1.3) 求解已有的基于黎曼优化的 Manopt 工具箱求解器[2 ,47 ] 和基于连续时间的投影梯度流算法[5 ,6 ] 的数值比较. 所有的数值结果均通过 Matlab(R2022b), $\text{Intel}^{\circledR}$
首先给出问题 (1.3) 中原始数据的生成方式, 算法迭代初值的选取和相关参数说明
$ \bullet $ $m$ $X_i, i=1, \cdots, m$ 13 ] 按如下方式生成: 方式一 (完全随机 (RAND)): 完全随机方式生成$X_i$
值得说明的是, 若采用完全随机的方式生成$X_i$ $Q\in \mathbb{R}^{n\times p}$ $D_i\in\mathbb{R}^{p\times p}$ ( $i=1,\cdots,m$ ). 根据 (1.1) 构造$X_i=Q{D_i}Q^T+E_i$ $E_i\in \mathbb{R}^{n\times n}$ $Q$ $[0,1]$ $D_i$ $E_i$ $\sigma^2$ $\sigma$ $Q{D_i}Q^T$
$ \bullet $ 5 ], 按如下方式生成迭代初值$Q^ {(0)}\in \mathcal{O}(n,p)$ $\sum_{i=1}^m X_i$ $p$ $\sum_{i=1}^m X_i\approx P_p\Lambda_p P_p^T$ $\Lambda_p\in \mathbb{R}^{p\times p}$ $p$ $P_p\in \mathbb{R}^{n\times p}$ $Q^{(0)}:=P_p$ . 对于下文中黎曼优化工具箱 Manopt 中算法及投影梯度流算法, 因需用到变量转换$D_i=\tilde{D}_i^2$ $\tilde{D}_i$ $Q^{(0)}$ $D_i^{(0)}$ $\tilde{D} _i^{(0)}$
(4.1) $\tilde{D}_{i}^{(0)}=\operatorname{sqrt}\left\{\max \left\{0, I_{p} \odot\left(Q^{(0)^{T}} X_{i} Q^{(0)}\right)\right\}\right\}, \quad i=1, \cdots, m$
$ \bullet $ $m$ $m=30$ $50$ $p$ $p\ll n$ $p=2$ $3$ $5$ . 考虑到多维标度分析的实际应用, 文中 $n$ $n\leq 100$ .
$ \bullet $ $k$ $k$ $k$ $k=5, 6, 7$ $k$ $X_i$ $X_i$ $(Q^{(j)}, D_1^{(j)}, \cdots, D_m^{(j)})$ $\mathrm{Error}\leq 10^{-1}$ $(Q^{(j)}, D_1^{(j)}, \cdots, D_m^{(j)})$ $\mathrm{Error}\leq 10^{0}$
$ \bullet $ $\varepsilon$ - 算法 (SEA, VEA, TEA 和 STEA) 的核心代码通过 MATLAB 工具箱 ${\tt EPSfun}$ [20 ] 来实现, 具体代码可通过网站 { http://www.netlib.org/numeralgo/ } 下载. 实验中拓扑 $\varepsilon$ - 算法选取 TEA2, 简化 $\varepsilon$ - 拓扑算法选取 STEA2-3. 因完全随机生成 $X_i$ $X_i$ $\mathrm{Error}\leq 10^{-6}$ $X_i$ $\mathrm{Error}\leq 10^{-8}$ $\mathrm{Error}$
4.1 结合 $\varepsilon$ - 算法的不动点迭代加速算法与原始不动点迭代算法的数值比较
本小节给出结合向量 $\varepsilon$ - 算法, 拓扑 $\varepsilon$ - 算法和简化拓扑 $\varepsilon$ - 算法的不动点迭代加速算法 (分别记为 ${\tt FPI-VEA}$ ${\tt FPI-TEA}$ $ {\tt FPI-STEA}$ ) 与原始不动点迭代算法 (记为 ${\tt FPI}$ ) 的数值比较. 针对简化拓扑 $\varepsilon$ - 算法 (各等价公式记为 ${\tt FPI-STEA1-1}$ ${\tt FPI-STEA1-2}$ ${\tt FPI-STEA1-3}$ ${\tt FPI-STEA1-4}$ ${\tt FPI-STEA2-1}$ ${\tt FPI-STEA2-2}$ ${\tt FPI-STEA2-3}$ ${\tt FPI-STEA2-4}$ ) , STEA1 比 STEA2 需额外存储前一条上升对角线上的偶数下标的元素, 因此在内存使用方面 STEA2 通常是更优的选择. 而 STEA2 四个等价公式中, 计算 STEA2-3 时所只涉及 SEA 偶数下标部分, 其余三个等价公式计算均涉及 SEA 奇数下标部分. 在本小节实验, 为了节约存储开销以及存储形式统一 (即只存储偶数下标的元素), 故 ${\tt FPI-STEA}$
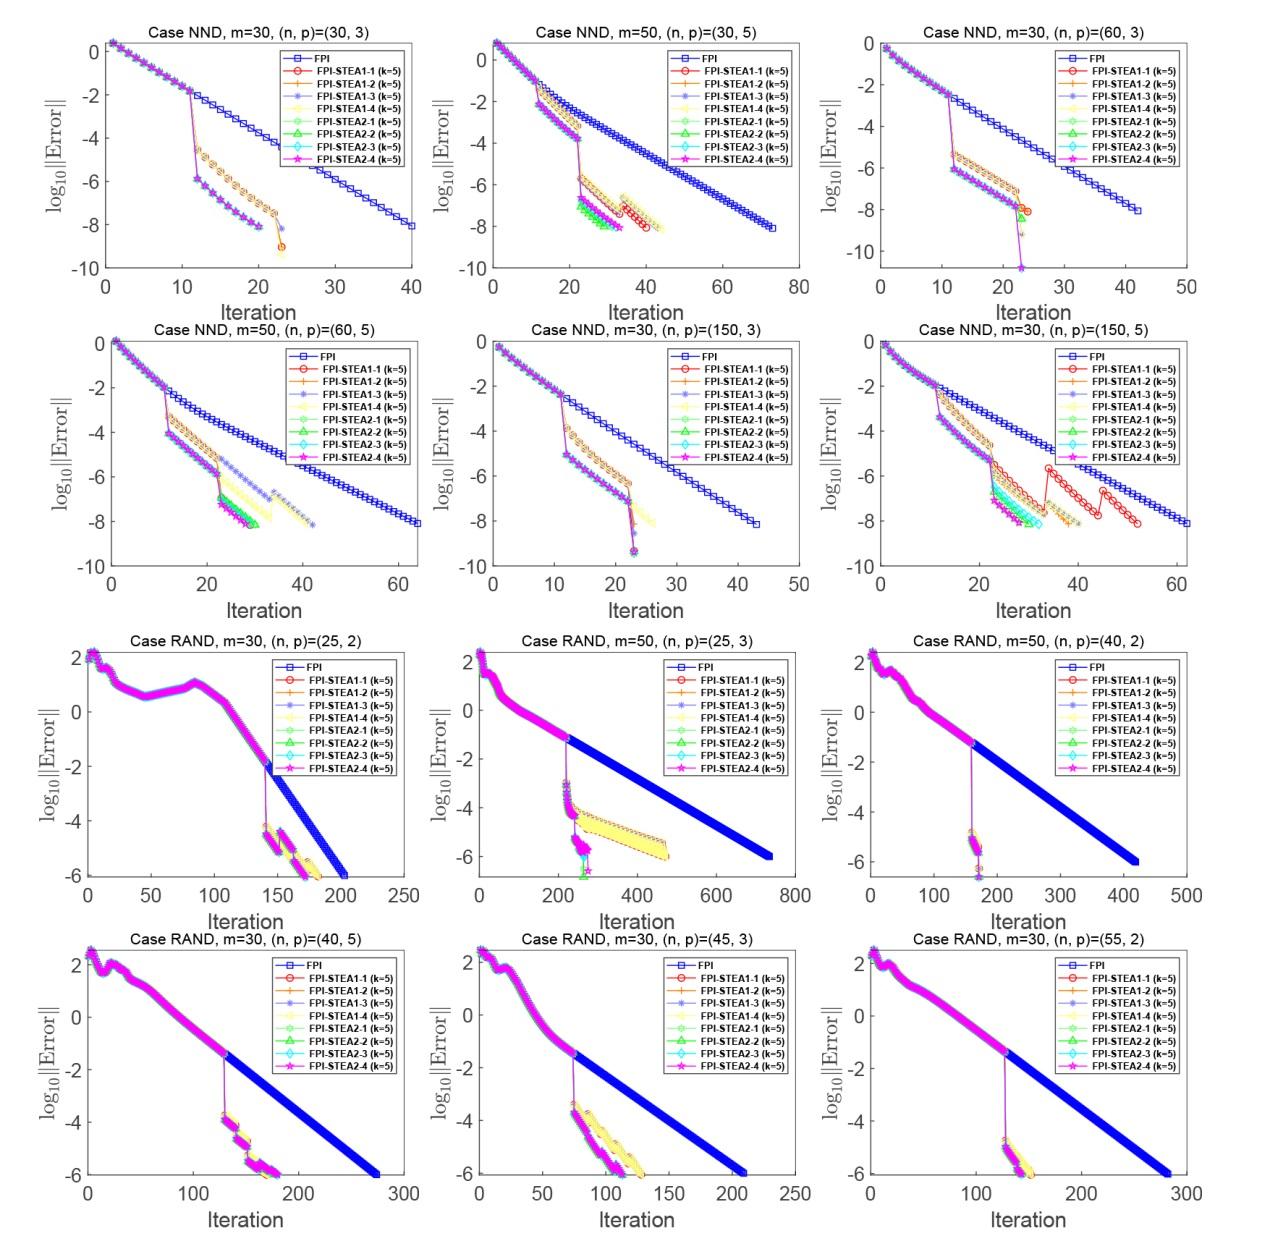
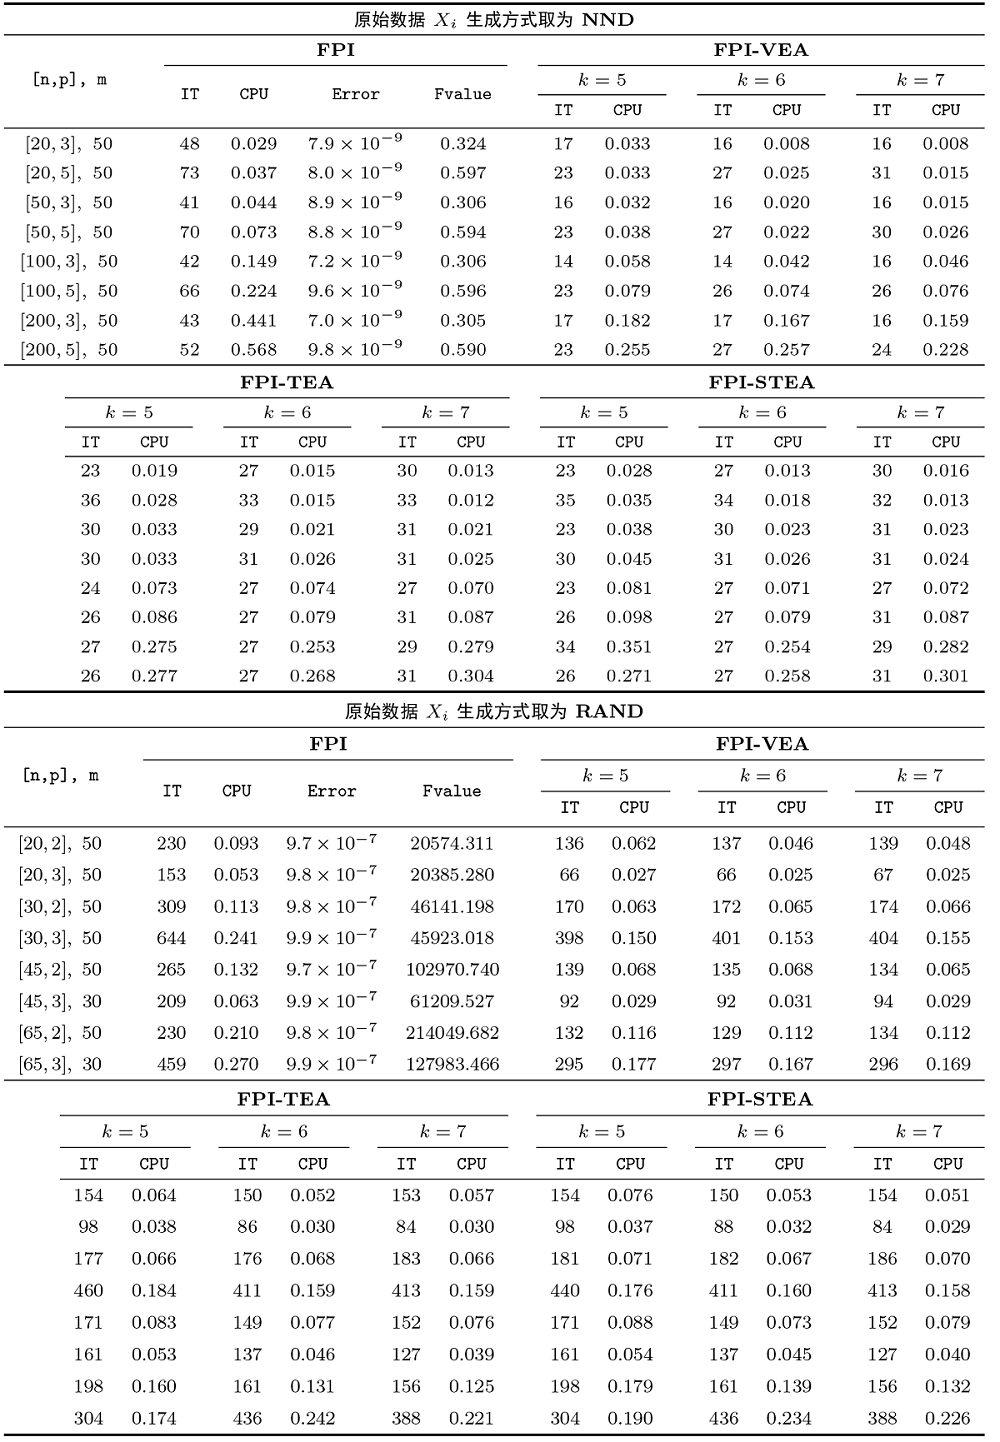
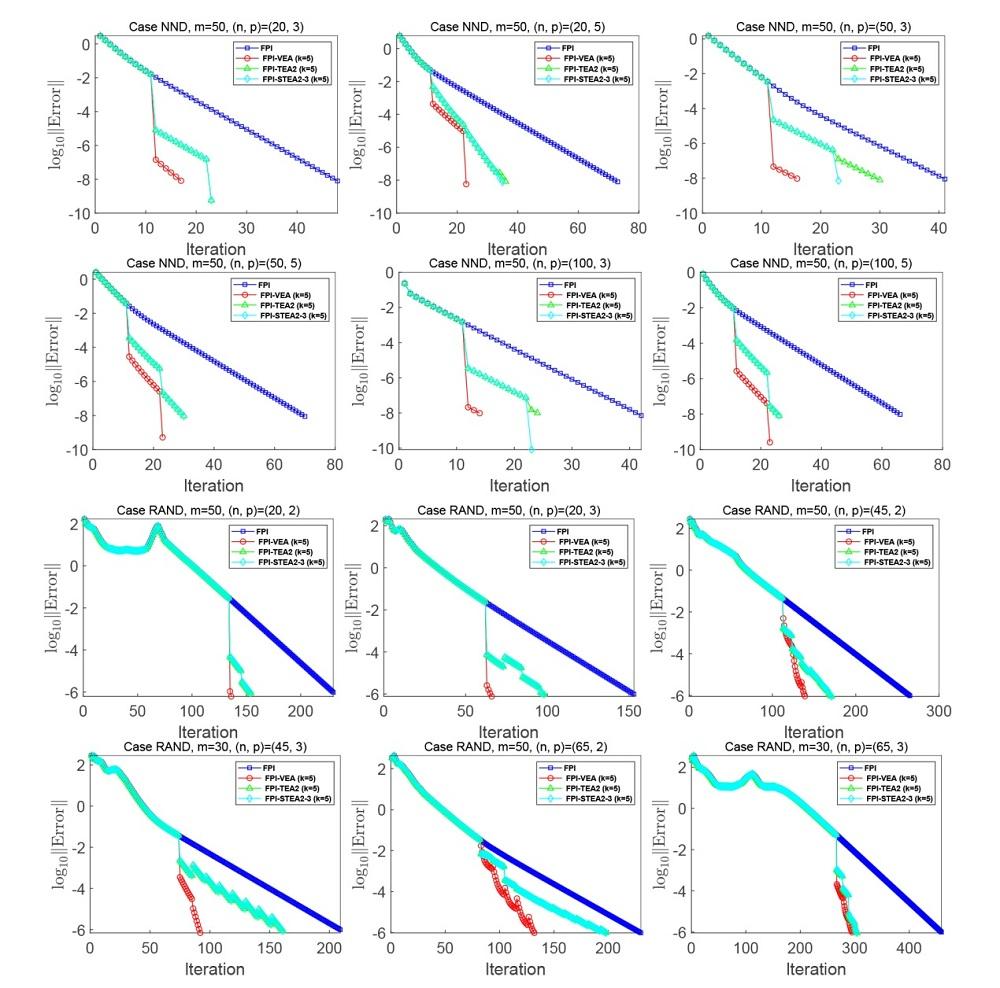
表4 给出了原始数据 $X_i$ $[n,p]$ $m$ $k$ $\varepsilon$ - 算法的原始不动点迭代数值比较结果, 其中 ${{\tt IT}}$ ${{\tt CPU}}$ ${\tt \mathrm{Error}}$ ${\tt \mathrm{Fvalue}}$ ${\tt FPI-STEA1-1}$ ${\tt FPI-STEA1-2}$ ${\tt FPI-STEA1-3}$ ${\tt FPI-STEA1-4}$ ${\tt FPI-STEA2-1}$ ${\tt FPI-STEA2-2}$ ${\tt FPI-STEA2-3}$ ${\tt FPI-STEA2-4}$ ${{\tt IT}}$ 图 1 给出了原始数据 $X_i$ $\varepsilon$ - 算法的加速窗口宽度取为 $k=5$ $\varepsilon$ - 算法与原始不动点迭代算法的误差范数$\text{log}_{10}\|\operatorname{Error}\|$ 表4 与图 1 的结果显示, STEA2 类的加速效果较 STEA1 表现更好.
图 1
图 1
原始数据 $X_i$ $k=5$ $\log _{10} \| \text { Error } \|$
表5 给出了原始数据 $X_i$ $[n,p]$ $m$ $k$ ${{\tt IT}}$ ${{\tt CPU}}$ ${\tt \mathrm{Error}}$ ${\tt \mathrm{Fvalue}}$ 表4 相同. 注意对于 ${\tt FPI-VEA}$ ${\tt FPI-TEA}$ ${\tt FPI-STEA}$ ${{\tt IT}}$ 图 2 给出了原始数据 $X_i$ $\varepsilon$ - 算法的加速窗口宽度取为 $k=5$ $\text{log}_{10}\|\operatorname{Error}\|$
图 2
图 2
原始数据 $X_i$ $k=5$ $\text{log}_{10}\|\operatorname{Error}\|$
对于原始数据$X_i$ $Q^{(0)}$ 图2 的前二行图中可以清晰地看出, 单个加速循环中经$2k+1$ $\varepsilon$ - 算法加速后得到一个下降明显的更新点. 对于生成方式 RAND, 因原始序列收敛较慢, 结合延迟启动执行加速算法. 从图2 的后二行图中可以看出, 即使在拟合误差较大的情形下, 含延迟启动的不动点迭代加速算法依然展现了良好的加速效果. 从表5 的数值结果同时可以看出, 加速窗口宽度 $k$ $k$ $\varepsilon$ - 算法所需的时间可能缩短, 带来加速效果的提升, 但单次加速循环的计算成本也相对增加.
4.2 结合 $\varepsilon$ - 算法的不动点迭代加速算法与结合多项式外推加速和 Anderson 加速的不动点迭代加速算法的数值比较
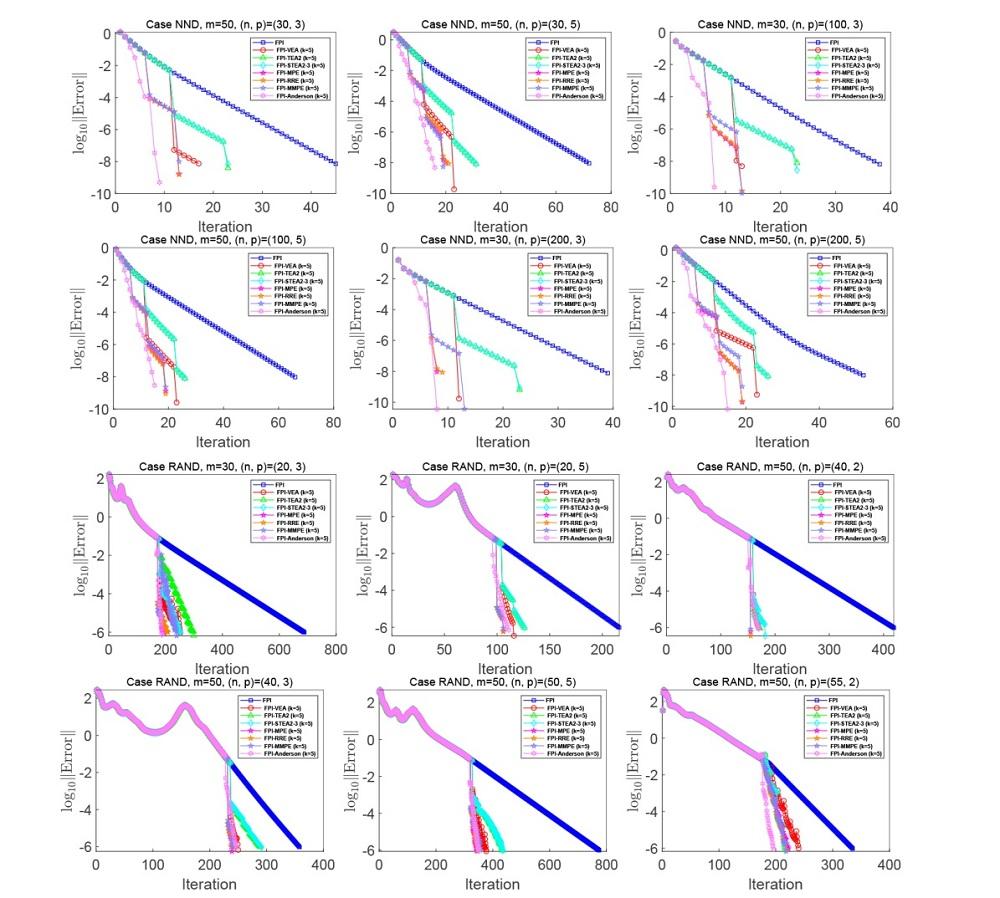
本小节给出结合 $\varepsilon$ - 算法的不动点迭代加速算法与文献[14 ] 提出的结合向量序列极小多项式外推加速 (记为 ${\tt FPI-MPE}$ ) , 降秩外推加速 (记为 ${\tt FPI-RRE}$ ) , 修正极小多项式外推加速 (记为 ${\tt FPI-MMPE}$ ) 和 Anderson 加速 (记为 ${\tt FPI-Anderson}$ ) 的不动点迭代加速算法的数值比较. 表 6 给出了原始数据 $X_i$ $[n,p]$ $m$ $k$ ${{\tt IT}}$ ${{\tt CPU}}$ ${\tt \mathrm{Error}}$ ${\tt \mathrm{Fvalue}}$ 表 5 . 需要说明的是, 同表 5 , 对于所有加速算法 (Anderson 加速除外), ${{\tt IT}}$ 图 3 给出了原始数据 $X_i$ $k=5$ $\text{log}_{10}\|\operatorname{Error}\|$
图 3
图 3
原始数据 $X_i$ $k=5$ $\text{log}_{10}\|\operatorname{Error}\|$
从表 6 中可以看出, 对于原始数据 $X_i$ ${\tt FPI-MPE}$ ${\tt FPI-RRE}$ ${\tt FPI-MMPE}$ ) 相比, 达到相同的迭代终止精度, $\varepsilon$ - 加速算法 (${\tt FPI-VEA}$ ${\tt FPI-TEA}$ ${\tt FPI-STEA}$ ) 通常需要更多的迭代步和迭代时间, 这是因为对于相同的加速窗口宽度 $k$ $\varepsilon$ - 加速算法需要 $2k+1$ ${\tt FPI-MPE}$ ${\tt FPI-RRE}$ ${\tt FPI-MMPE}$ $k+1$ [14 ,45 ] . 但值得说明的是 ${\tt FPI-TEA}$ ${\tt FPI-STEA}$ $\varepsilon$ - 算法的不动点迭代加速算法与结合多项式外推加速和 Anderson 加速的不动点迭代加速算法相比具有可比较的加速效果.
4.3 结合 $\varepsilon$ - 算法的不动点迭代加速算法与工具箱 Manopt 中已有算法的数值比较
2021 年, Trendafilov 和 Gallo 在专著 [2 ] 中从矩阵流形角度系统总结了多种经典多维数据分析模型, 并针对 MDS 中的 O-INDSCAL
问题 (1.3) 设计了基于黎曼优化工具箱 Manopt[47 ] 的算法框架. 本小节给出 ${\tt FPI-VEA}$ ${\tt FPI-TEA}$ ${\tt FPI-STEA}$
(4.2) $\begin{equation}\label{problem111} \begin{array}{rl} \min &\quad \tilde{f}(Q,{\bar{D}_1},\cdots,{\tilde{D}_m})=\dfrac{1}{2}\sum\limits^m_{i=1}\|X_i-Q{\tilde{D}_i}^2Q^T\|^2\\ \operatorname{s.\ t.}&\quad (Q,{\tilde{D}_1},\cdots,{\tilde{D}_m})\in \mathcal{O}(n,p)\times\Omega(p)^m, \end{array}\end{equation} $
其中 $\Omega(p)$ $p$ 14 ,第 4.3 小节], 更多关于基于黎曼优化求解 MDS 中各类矩阵优化模型的文献可参考文献 [48 50]. 基于一阶最优性条件, 利用黎曼优化算法求解问题 (4.2) 的终止标准均取为
(4.3) $\begin{equation}\label{nv} \mathrm{Error}=\mathrm{grad}\ \widetilde{f}({Q^{(j)},\ {\widetilde{D}_1}^{(j)},\ \cdots,\ {\widetilde{D}_m}^{(j)}})\leq 10^{-6}. \end{equation}$
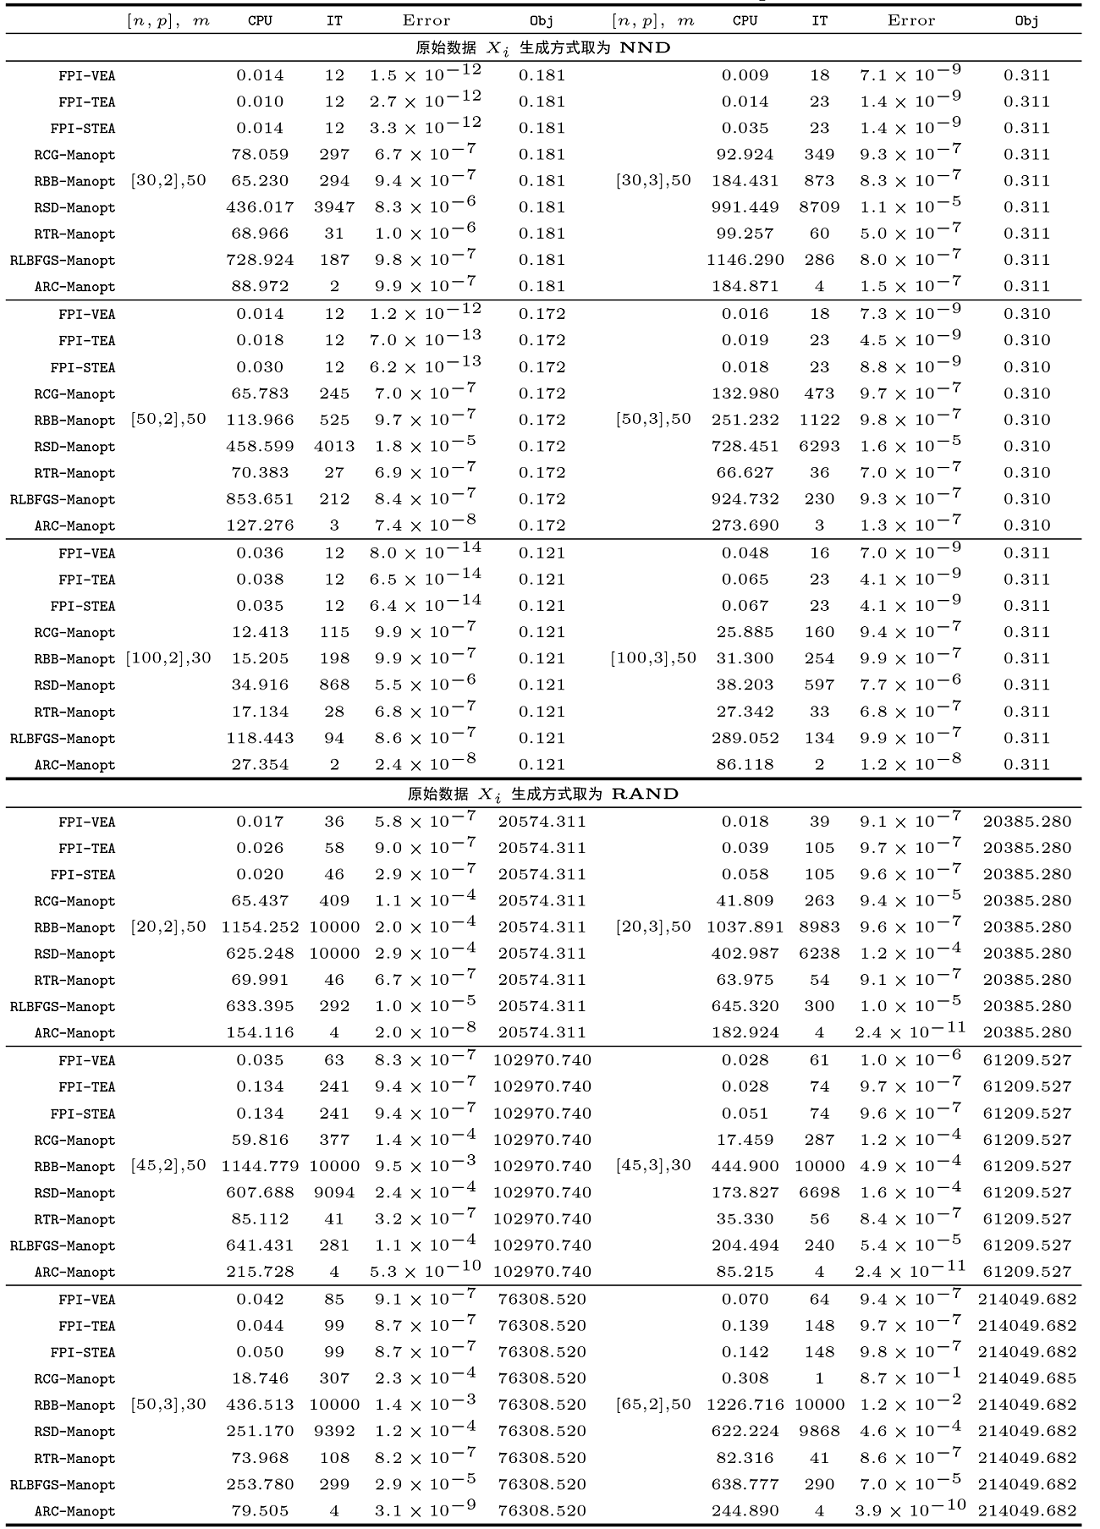
表 7 给出了原始数据 $X_i$ $k=5$ ${\tt FPI-VEA}$ ${\tt FPI-TEA}$ ${\tt FPI-STEA}$ ${\tt RSD-Manopt}$ ) , 共轭梯度法 (${\tt RCG-Manopt}$ ) , Barzilai-Borwein 算法 (${\tt RBB-Manopt}$ ) , BFGS 算法 (${\tt RLBFGS-Manopt}$ ) , 信赖域算法 (${\tt RTR-Manopt}$ ) 和自适应立方正则化算法 (${\tt ARC-Manopt}$ ). 黎曼优化类算法中的参数选取均采用工具箱中的默认参数. 表 7 中 ${{\tt CPU}}$ ${{\tt IT}}$ $X_i$ ${{\tt CPU}}$ ${{\tt IT}}$ ${{\tt Obj}} $ $f$ $\widetilde{f}$ ${{\tt Error}}$ 图 4 给出了原始数据 $X_i$ $\text{log}_{10}\|\operatorname{Error}\|$ 表 7 和图 4 的数值结果表明, 与黎曼优化工具箱 Manopt 中已有的黎曼一阶和二阶算法相比, 不动点迭代加速算法在迭代效率上具有较为明显的优势.
图4
图4
原始数据 $X_i$ $k=5$ $\text{log}_{10}\|\operatorname{Error}\|$
4.4 结合 $\varepsilon$ - 算法的不动点迭代加速算法与投影梯度流算法的数值比较
针对 O-INDSCAL 问题 (1.3), Trendafilov[2 ,5 ,6 ] 将其转化为一类约束可行集下的梯度动力系统, 并设计了基于连续时间的投影梯度流求解算法. 更多基于投影梯度流算法求解多维数据分析中其它矩阵优化模型的研究参考文献 [8 11]. 本小节给出 ${\tt FPI-VEA}$ ${\tt FPI-TEA}$ ${\tt FPI-STEA}$
对于约束优化问题$\mathop{\min}_{X\in \mathcal{M}} E(X)$ $X_0\in \mathcal{M}$ $X_1, \cdots, X_t, \cdots$
其中$h_t$ $t$ $\pi_\mathcal{M}(X)$ $\mathcal{M}$
针对与 O-INDSCAL 问题 (1.3) 等价的优化问题 (4.2), 应用投影梯度流方向, 对应的微分方程为
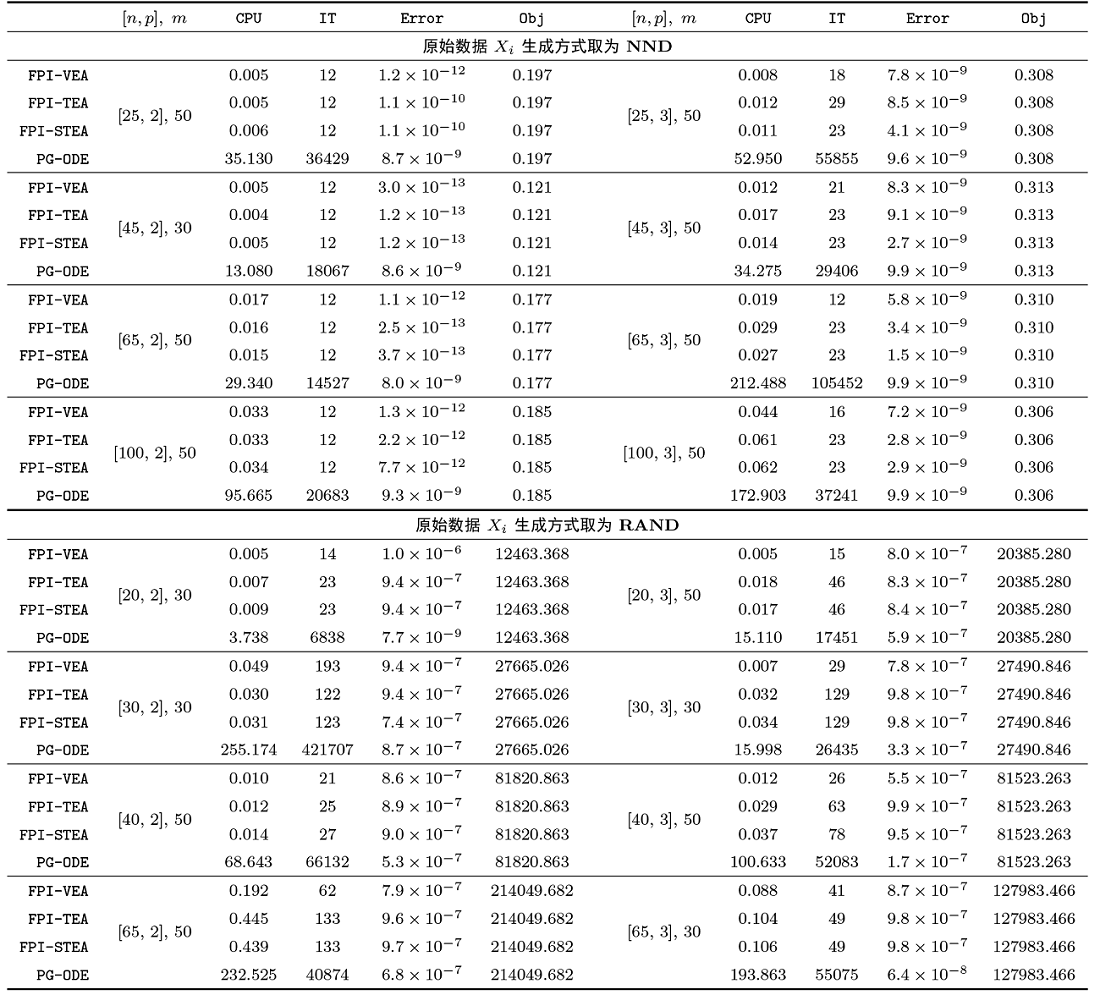
其中$J_i=X_i-Q\widetilde{D}_i^2Q^{{T}}$ . 给定初始迭代点$(Q^{(0)}, \tilde{D}_1^{(0)}, \cdots, \tilde{D}_m^{(0)})\in \mathcal{O}(n,p)\times\Omega(p)^m$ ${\tt ode15s}$ 表8 给出了原始数据 $X_i$ $k=5$ ${\tt FPI-VEA}$ ${\tt FPI-TEA}$ ${\tt FPI-STEA}$ ${\tt ode15s}$ ${\tt PG-ODE})$ ${{\tt CPU}}$ ${{\tt IT}}$ ${{\tt Obj}}$ ${{\tt Error}}$ 表 7. 表 8 的数值结果表明, 与投影梯度流算法相比, 不动点迭代加速算法在迭代效率上同样具有较为明显的优势.
5 总结
本文从数值角度研究了多维标度分析中一类考虑观测对象之间个体差异的个体差异标度模型 O-INDSCAL. 该模型可归纳为具有列正交和非负对角约束的多变量约束矩阵优化问题 (问题 (1.3)). 基于交替最小二乘迭代思想, 本文首先将原始模型求解转化为一类矩阵形式不动点迭代问题. 进而结合向量序列加速中的 $\varepsilon$ - 加速原理设计基于向量 $\varepsilon$ - 算法, 拓扑 $\varepsilon$ - 算法和简化版拓扑 $\varepsilon$ - 算法的不动点迭代加速算法 (${\tt FPI-VEA}$ ${\tt FPI-TEA}$ ${\tt FPI-STEA}$ ). 较充分的数值实验结果表明, 针对 O-INDSCAL 问题 (1.3) 求解, 与原始不动点迭代算法相比, 结合 $\varepsilon$ - 算法的不动点迭代加速算法具有良好的加速收敛效果; 同时与求解多维数据分析中矩阵优化模型已有的基于黎曼优化的 Manopt 工具箱算法和经典的投影梯度流算法相比, 不动点迭代加速算法在迭代时间上具有较为明显的优势. 提高迭代方法生成的标量, 向量, 矩阵或张量序列的收敛速度在科学与工程计算和机器学习等领域具有重要意义. 值得说明的是, 与传统的向量序列多项式外推加速应用于求解矩阵优化模型不同的是, ${\tt FPI-TEA}$ ${\tt FPI-STEA}$
参考文献
View Option
[1]
Borg I Groenen P J Modern Multidimensional Scaling:Theory and Applications . New York : Springer Science & Business Media , 2005
[本文引用: 1]
[2]
Trendafilov N Gallo M Multivariate Data Analysis on Matrix Manifolds . Berlin : Springer , 2021
[本文引用: 9]
[3]
Carroll J D Chang J J Analysis of individual differences in multidimensional scaling via an N-way generalization of "Eckart-Young" decomposition
Psychometrika , 1970 , 35 3 ): 283 -319
DOI:10.1007/BF02310791
URL
[本文引用: 2]
An individual differences model for multidimensional scaling is outlined in which individuals are assumed differentially to weight the several dimensions of a common “psychological space”. A corresponding method of analyzing similarities data is proposed, involving a generalization of “Eckart-Young analysis” to decomposition of three-way (or higher-way) tables. In the present case this decomposition is applied to a derived three-way table of scalar products between stimuli for individuals. This analysis yields a stimulus by dimensions coordinate matrix and a subjects by dimensions matrix of weights. This method is illustrated with data on auditory stimuli and on perception of nations.
[4]
Husson F Pagès J INDSCAL model: geometrical interpretation and methodology
Computational Statistics & Data Analysis , 2006 , 50 2 ): 358 -378
[本文引用: 1]
[5]
Trendafilov N T Orthonormality-Constrained INDSCAL with Nonnegative Saliences .//International Conference on Computational Science and Its Applications, Berlin : Springer , 2004 : 952 -960
[本文引用: 7]
[6]
Trendafilov N T The dynamical system approach to multivariate data analysis
Journal of Computational and Graphical Statistics , 2006 , 15 3 ): 628 -650
DOI:10.1198/106186006X130828
URL
[本文引用: 6]
[7]
ten Berge J M Kiers H A de Leeuw J Explicit CANDECOMP/PARAFAC solutions for a contrived 2 $\times$ $\times$
Psychometrika , 1988 , 53 4 ): 579 -583
DOI:10.1007/BF02294409
URL
[本文引用: 1]
[8]
Trendafilov N T GIPSCAL revisited. A projected gradient approach
Statistics and Computing , 2002 , 12 2 ): 135 -145
[本文引用: 2]
[9]
Trendafilov N T Dynamical system approach to factor analysis parameter estimation
British Journal of Mathematical and Statistical Psychology , 2003 , 56 1 ): 27 -46
DOI:10.1348/000711003321645322
URL
[10]
Trendafilov N T Jolliffe I T Projected gradient approach to the numerical solution of the SCoTLASS
Computational Statistics & Data Analysis , 2006 , 50 1 ): 242 -253
[11]
Trendafilov N T DINDSCAL: direct INDSCAL
Statistics and Computing , 2012 , 22 445 -454
[本文引用: 2]
[12]
Tendeiro J Dosse M B Berge J M T First and second-order derivatives for CP and INDSCAL
Chemometrics and Intelligent Laboratory Systems , 2011 , 106 1 ): 27 -36
DOI:10.1016/j.chemolab.2010.05.013
URL
[本文引用: 2]
[13]
Takane Y Jung K Hwang H et al . An acceleration method for Ten Berge et al.'s algorithm for orthogonal INDSCAL
Computational Statistics , 2010 , 25 3 ): 409 -428
[本文引用: 6]
[14]
陈新 , 覃月凤 , 周学林 , 李姣芬 . 多维标度中个体差异标度模型的向量序列加速算法
计算数学 , 2025 , 47 2 ): 255 -284
DOI:10.12286/jssx.j2024-1213
[本文引用: 9]
多维标度分析是一种在低维空间中以点间距离展现观测对象之间相似性测度或亲疏关系的多维数据分析方法, 其通过在低维空间中表示高维数据, 保留数据点之间的相对距离关系. 本文主要针对对称多维标度中一类考虑观测对象之间个体差异的个体差异标度模型(O-INDSCAL)设计有效的数值求解算法. 首先基于交替最小二乘迭代算法思想将模型对应的多变量约束矩阵优化问题转换为不动点迭代问题, 并结合向量序列加速原理给出加速算法的具体实施过程, 进而设计适应问题模型的基于极小多项式外推加速, 降秩外推加速和修正极小多项式外推加速, 以及Anderson加速的不动点迭代加速算法. 数值实验说明表明所考虑的加速算法均可提高由不动点迭代生成序列的收敛速度, 同时较O-INDSCAL 模型求解已有的基于连续时间的投影梯度流算法和基于流形优化的黎曼优化工具箱Manopt中若干黎曼一阶和二阶算法在迭代效率上均有较为明显的优势.
Chen X Qin Y Zhou X Li J Vector sequence acceleration algorithms for the INDSCAL model in multidimensional scaling analysis
Mathematica Numerica Sinica , 2025 , 47 2 ): 255 -284
DOI:10.12286/jssx.j2024-1213
[本文引用: 9]
Multidimensional scaling (MDS) is a technique used in multidimensional data analysis that depicts the similarities or relationships between observed objects as distances between points in a lower-dimensional space. By representing high-dimensional data within a lowdimensional framework, MDS preserves the relative distances between data points. This study focuses on developing an efficient numerical algorithm for a specific type of individual differences scaling model, known as O-INDSCAL, within symmetric multidimensional scaling, which accounts for individual differences among observed objects. Initially, leveraging the concept of the alternating least squares algorithm, the multivariable constrained matrix optimization model associated with the O-INDSCAL model is transformed into a fixed-point iteration problem. By thoroughly examining the acceleration principles and implementation processes of various polynomial extrapolation and Anderson acceleration methods in vector sequence acceleration, we have designed a matrix sequence acceleration algorithm tailored to this problem model. Numerical experiments indicate that the proposed acceleration algorithms significantly enhance the convergence speed of sequences generated by fixed-point iterations. Furthermore, when compared with existing continuous-time projection gradient flow algorithms and the first-order and second-order Riemannian algorithms available in the Manopt toolbox for manifold optimization, the proposed algorithms demonstrate notable improvements in iterative efficiency.
[15]
Shanks D Non-linear transformations of divergent and slowly convergent sequences
Journal of Mathematics and Physics , 1955 , 34 1-4 ): 1 -42
DOI:10.1002/sapm.v34.1
URL
[本文引用: 2]
[16]
Wynn P On a device for computing the $e_m (S_n)$
Mathematical Tables and Other Aids to Computation , 1956 : 91 -96
[本文引用: 3]
[18]
Brezinski C Zaglia M R Extrapolation Methods:Theory and Practice . Amsterdam : Elsevier , 2013
[本文引用: 3]
[19]
Brezinski C Redivo-Zaglia M The simplified topological $\varepsilon$ - algorithms for accelerating sequences in a vector space
SIAM Journal on Scientific Computing , 2014 , 36 5 ): A2227 -A2247
DOI:10.1137/140957044
URL
[本文引用: 4]
[20]
Brezinski C Redivo-Zaglia M The simplified topological $\varepsilon$ - algorithms: software and applications
Numerical Algorithms , 2017 , 74 1237 -1260
DOI:10.1007/s11075-016-0238-0
URL
[本文引用: 17]
[21]
Saâdaoui F Quadratic extrapolation for accelerating convergence of the EM fixed point problem
Journal of Computational and Applied Mathematics , 2020 , 369 112577
DOI:10.1016/j.cam.2019.112577
URL
[本文引用: 1]
[22]
Chehab J P Raydan M Geometrical inverse matrix approximation for least-squares problems and acceleration strategies
Numerical Algorithms , 2020 , 85 1213 -1231
DOI:10.1007/s11075-019-00862-z
[23]
Brezinski C Cipolla S Redivo-Zaglia M Saad Y Shanks and Anderson-type acceleration techniques for systems of nonlinear equations
IMA Journal of Numerical Analysis , 2022 , 42 4 ): 3058 -3093
DOI:10.1093/imanum/drab061
This paper examines a number of extrapolation and acceleration methods and introduces a few modifications of the standard Shanks transformation that deal with general sequences. One of the goals of the paper is to lay out a general framework that encompasses most of the known acceleration strategies. The paper also considers the Anderson Acceleration (AA) method under a new light and exploits a connection with quasi-Newton methods in order to establish local linear convergence results of a stabilized version of the AA method. The methods are tested on a number of problems, including a few that arise from nonlinear partial differential equations.
[24]
He H Tang Z Zhao S Saad Y Xi Y nltgcr: A class of nonlinear acceleration procedures based on conjugate residuals
SIAM Journal on Matrix Analysis and Applications , 2024 , 45 1 ): 712 -743
DOI:10.1137/23M1576360
URL
[25]
Saâdaoui F Accelerated numerical solutions for discretized Black-Scholes equations
IMA Journal of Management Mathematics , 2026 , 37 1 ): 273 -293
DOI:10.1093/imaman/dpae006
URL
[26]
Azzarelli A Brezinski C Fenu C et al . Parameter Choice Rules for Discrete Ill-Posed Problems Based on Extrapolation Methods
Journal of Scientific Computing , 2025 , 103 1 ): Art 9
DOI:10.1007/s10915-025-02822-3
[本文引用: 1]
[27]
Gazzola S Karapiperi A Image reconstruction and restoration using the simplified topological $\varepsilon$ - algorithm
Applied Mathematics and Computation , 2016 , 274 539 -555
DOI:10.1016/j.amc.2015.11.027
URL
[本文引用: 1]
[28]
Gander W Shi Q Matrix completion with $\varepsilon$ - algorithm: In memory of Peter Wynn (1931-2017)
Numerical Algorithms , 2019 , 80 1 ): 279 -301
DOI:10.1007/s11075-018-0579-y
[本文引用: 1]
[29]
Cipolla S Redivo-Zaglia M Tudisco F Extrapolation methods for fixed-point multilinear PageRank computations
Numerical Linear Algebra with Applications , 2020 , 27 2 ): e2280
DOI:10.1002/nla.v27.2
URL
[本文引用: 1]
[30]
Hiriart-Urruty J B Lemaréchal C Convex Analysis and Minimization Algorithms I: Fundamentals . Berlin : Springer , 1996
[32]
Duminil S Sadok H Silvester D Fast solvers for discretized Navier-Stokes problems using vector extrapolation
Numerical Algorithms , 2014 , 66 89 -104
DOI:10.1007/s11075-013-9726-7
URL
[本文引用: 1]
[33]
Higham N J Strabić N Anderson acceleration of the alternating projections method for computing the nearest correlation matrix
Numerical Algorithms , 2016 , 72 1021 -1042
DOI:10.1007/s11075-015-0078-3
URL
[34]
An H Jia X Walker H F Anderson acceleration and application to the three-temperature energy equations
Journal of Computational Physics , 2017 , 347 1 -19
[35]
Awasthi N Kalva S K Pramanik M Yalavarthy P K Vector extrapolation methods for accelerating iterative reconstruction methods in limited-data photoacoustic tomography
Journal of Biomedical Optics , 2018 , 23 7 ): Art 071204
[36]
Pollock S Rebholz L G Xiao M Anderson-accelerated convergence of Picard iterations for incompressible Navier-Stokes equations
SIAM Journal on Numerical Analysis , 2019 , 57 2 ): 615 -637
DOI:10.1137/18M1206151
We propose, analyze, and test Anderson-accelerated Picard iterations for solving the incompressible Navier-Stokes equations (NSE). Anderson acceleration has recently gained interest as a strategy to accelerate linear and nonlinear iterations, based on including an optimization step in each iteration. We extend the Anderson acceleration theory to the steady NSE setting and prove that the acceleration improves the convergence rate of the Picard iteration based on the success of the underlying optimization problem. The convergence is demonstrated in several numerical tests, with particularly marked improvement in the higher Reynolds number regime. Our tests show it can be an enabling technology in the sense that it can provide convergence when both usual Picard and Newton iterations fail.
[37]
Nazer S A Jazar M Rosier C Convergence acceleration of iterative sequences for equilibrium chemistry computations
Computational Geosciences , 2021 , 25 5 ): 1509 -1538
DOI:10.1007/s10596-021-10054-1
[38]
Lai F Li W Peng X Chen Y Anderson accelerated fixed-point iteration for multilinear PageRank
Numerical Linear Algebra with Applications , 2023 , 30 5 ): e2499
DOI:10.1002/nla.v30.5
URL
[40]
Brezinski C Redivo-Zaglia M Saad Y Shanks sequence transformations and Anderson acceleration
SIAM Review , 2018 , 60 3 ): 646 -669
DOI:10.1137/17M1120725
URL
[本文引用: 2]
This paper presents a general framework for Shanks transformations of sequences of elements in a vector space. It is shown that Minimal Polynomial Extrapolation (MPE), Modified Minimal Polynomial Extrapolation (MMPE), Reduced Rank Extrapolation (RRE), the Vector Epsilon Algorithm (VEA), the Topological Epsilon Algorithm (TEA), and Anderson Acceleration (AA), which are standard general techniques designed to accelerate arbitrary sequences and/or solve nonlinear equations, all fall into this framework. Their properties and their connections with quasi-Newton and Broyden methods are studied. The paper then exploits this framework to compare these methods. In the linear case, it is known that AA and GMRES are “essentially” equivalent in a certain sense, while GMRES and RRE are mathematically equivalent. This paper discusses the connection between AA, the RRE, the MPE, and other methods in the nonlinear case.
[41]
Brezinski C Convergence acceleration during the 20th century
Journal of Computational and Applied Mathematics , 2000 , 122 1/2 ): 1 -21
DOI:10.1016/S0377-0427(00)00360-5
URL
[42]
d' Aspremont A Scieur D Taylor A Acceleration methods
Foundations and Trends® in Optimization , 2021 , 5 1/2 ): 1 -245
DOI:10.1561/OPT
URL
[44]
Brezinski C Redivo-Zaglia M The genesis and early developments of Aitken's process, Shanks' transformation, the $\varepsilon$ - algorithm, and related fixed point methods
Numerical Algorithms , 2019 , 80 1 ): 11 -133
DOI:10.1007/s11075-018-0567-2
[本文引用: 1]
In this paper, we trace back the genesis of Aitken's (2) process and Shanks' sequence transformation. These methods, which are extrapolation methods, are used for accelerating the convergence of sequences of scalars, vectors, matrices, and tensors. They had, and still have, many important applications in numerical analysis and in applied mathematics. They are related to continued fractions and Pade approximants. We go back to the roots of these methods and analyze the original contributions. New and detailed explanations on the building and properties of Shanks' transformation and its kernel are provided. We then review their historical algebraic and algorithmic developments. We also analyze how they were involved in the solution of systems of linear and nonlinear equations, in particular in the methods of Steffensen, Pulay, and Anderson. Testimonies by various actors of the domain are given. The paper can also serve as an introduction to this domain of numerical analysis.
[45]
Sidi A Vector Extrapolation Methods with Applications
Philadelphia: SIAM , 2017
[本文引用: 2]
[46]
Absil P A Mahony R Sepulchre R Optimization Algorithms on Matrix Manifolds . Princeton : Princeton University Press , 2008
[本文引用: 2]
[47]
Boumal N Mishra B Absil P A Sepulchre R Manopt, a Matlab toolbox for optimization on manifolds
Journal of Machine Learning Research , 2014 , 15 1 ): 1455 -1459
[本文引用: 2]
[48]
Li J Zhou J Zhou X et al . A trust-region approach for iteration solution of the direct fitting metric MDS
BIT Numerical Mathematics , 2025 , 65 2 ): 1 -37
DOI:10.1007/s10543-024-01045-6
[本文引用: 1]
[49]
Zhou X Li J Li C An efficient algorithm for fitting the three-way GIPSCAL problem with missing values from asymmetric multidimensional scaling
Numerical Algorithms , 2025 , 1 -42 . Online, https://doi.org/10.1007/s11075-025-02136-3
URL
[50]
Zhou X Li C Li J Duan X A Riemannian inexact Newton method for solving the orthogonal INDSCAL problem in multidimensional scaling
IMA Journal of Numerical Analysis , https://doi.org/10.1093/imanum/draf047 , 2025
URL
[本文引用: 1]
1
2005
... 多维标度分析 (Multidimensional Scaling, MDS) 是一种经典统计方法, 用于将高维数据映射到低维空间, 以可视化数据点之间的相似性或距离关系. 其核心在于尽可能保留原始数据中的距离信息, 从而在二维或三维空间中直观地呈现数据结构. MDS 广泛应用于心理学、市场研究、遗传学等多个领域, 尤其在复杂数据的降维和可视化过程中发挥着关键作用, 帮助研究人员发现潜在的模式和群体. 常见的 MDS 包括经典 (度量) MDS 和非度量 MDS, 具体内容详见近年的专著[1 ,2 ] . 本文主要研究对称 MDS 中的个体差异标度模型 (Individual Differences Scaling, INDSCAL), 该模型针对多个对称数据矩阵进行同步 MDS, 能够更有效地捕捉不同个体之间的尺度差异. ...
9
2021
... 多维标度分析 (Multidimensional Scaling, MDS) 是一种经典统计方法, 用于将高维数据映射到低维空间, 以可视化数据点之间的相似性或距离关系. 其核心在于尽可能保留原始数据中的距离信息, 从而在二维或三维空间中直观地呈现数据结构. MDS 广泛应用于心理学、市场研究、遗传学等多个领域, 尤其在复杂数据的降维和可视化过程中发挥着关键作用, 帮助研究人员发现潜在的模式和群体. 常见的 MDS 包括经典 (度量) MDS 和非度量 MDS, 具体内容详见近年的专著[1 ,2 ] . 本文主要研究对称 MDS 中的个体差异标度模型 (Individual Differences Scaling, INDSCAL), 该模型针对多个对称数据矩阵进行同步 MDS, 能够更有效地捕捉不同个体之间的尺度差异. ...
... INDSCAL 模型求解问题旨在寻找满足上述约束条件的矩阵集$(Q, D_1, \cdots, D_m)$ $m$ $n \times n$ $X_i (i = 1, \cdots, m)$ [2 ,5 ,6 ] ...
... 其中 $\|\cdot\|$ $D_i$ $m$ $D_i$ [3 ] 提出了基于交替最小二乘法 (Alternating Least Squares, ALS) 的标量算法 CANDECOMP 用于求解原始 INDSCAL 模型. 然而, 即使在 $X_i$ $D_i$ [7 ] . 注意到 (1.2) 式中关于 $Q$ $Q$ $D_i$ $Q$ [2 ,5 ,6 ] 考虑了具有非负显著性权重的一类正交性 INDSCAL 问题 (O-INDSCAL), 即在$Q^T Q = I_p$ $D_i$ [2 ,5 ,6 ] ...
... [2 ,5 ,6 ] ...
... 由于 O-INDSCAL 模型本身的复杂性且变量 $Q$ $D_i$ [5 ,6 ] 将其转化为一类约束可行集下的梯度动力系统, 并设计了基于连续时间的投影梯度流求解算法. 该方法具有全局收敛性且算法易于实现, 同时在多维数据分析中其它矩阵优化模型求解上可推广性强[8 11 ] . 但在处理大规模问题时, 算法效率可能受限. Tendeiro[12 ] 从优化角度研究问题 (1.3) 的一阶和二阶最优化条件. 针对问题 (1.3), Takane[13 ] 给出了近似 ALS 迭代方案, 同时为克服 ALS 方法生成序列收敛较慢的缺点, 将向量序列加速中的极小多项式外推加速 (MPE) 方案应用于该矩阵序列. 数值实验表明, 在数据规模较小的情况下加速效果明显. 文献[14 ] 进一步将向量序列加速中的降秩外推加速 (RRE) 和修正极小多项式外推加速 (MMPE) 以及 Anderson 加速应用于求解问题 (1.3). 2021 年 Trendafilov 和 Gallo[2 ] 从矩阵流形角度系统总结了 MDS 中的若干经典模型, 同时针对 O-INDSCAL 模型给出了基于黎曼优化工具箱 Manopt 的算法框架. ...
... 其中$\epsilon$ $\mathcal{P}_{{\mathbf{T}_{Q}}\mathcal{O}(n,p)}$ $\mathcal{O}(n,p)$ $Q$ ${\mathbf{T}_{Q}\mathcal{O}(n,p)}$ 2 ,46 ], $\forall M\in \mathbb{R}^{n\times p}$
... 本节给出数值实验说明结合 $\varepsilon$ - 算法的不动点迭代加速算法应用于求解 O-INDSCAL 问题 (1.3) 的数值效果. 首先给出结合 $\varepsilon$ - 算法的不动点迭代加速算法与原始不动点迭代的数值比较, 进而给出结合 $\varepsilon$ - 算法的不动点迭代加速算法与文献[14 ] 提出的结合向量序列多项式外推加速的不动点迭代加速算法和结合 Anderson 加速的不动点迭代加速算法的数值比较. 同时给出加速算法与问题 (1.3) 求解已有的基于黎曼优化的 Manopt 工具箱求解器[2 ,47 ] 和基于连续时间的投影梯度流算法[5 ,6 ] 的数值比较. 所有的数值结果均通过 Matlab(R2022b), $\text{Intel}^{\circledR}$
... 2021 年, Trendafilov 和 Gallo 在专著 [2 ] 中从矩阵流形角度系统总结了多种经典多维数据分析模型, 并针对 MDS 中的 O-INDSCAL ...
... 针对 O-INDSCAL 问题 (1.3), Trendafilov[2 ,5 ,6 ] 将其转化为一类约束可行集下的梯度动力系统, 并设计了基于连续时间的投影梯度流求解算法. 更多基于投影梯度流算法求解多维数据分析中其它矩阵优化模型的研究参考文献 [8 11 ]. 本小节给出 ${\tt FPI-VEA}$ ${\tt FPI-TEA}$ ${\tt FPI-STEA}$
Analysis of individual differences in multidimensional scaling via an N-way generalization of "Eckart-Young" decomposition
2
1970
... INDSCAL 模型最早由 Carroll 和 Chang[3 ] 提出, 其模型几何解释见文献[4 ]. 在 MDS 的基础上, INDSCAL 模型通过对 $m$ $n$ $X_i$ $n$
... 其中 $\|\cdot\|$ $D_i$ $m$ $D_i$ [3 ] 提出了基于交替最小二乘法 (Alternating Least Squares, ALS) 的标量算法 CANDECOMP 用于求解原始 INDSCAL 模型. 然而, 即使在 $X_i$ $D_i$ [7 ] . 注意到 (1.2) 式中关于 $Q$ $Q$ $D_i$ $Q$ [2 ,5 ,6 ] 考虑了具有非负显著性权重的一类正交性 INDSCAL 问题 (O-INDSCAL), 即在$Q^T Q = I_p$ $D_i$ [2 ,5 ,6 ] ...
INDSCAL model: geometrical interpretation and methodology
1
2006
... INDSCAL 模型最早由 Carroll 和 Chang[3 ] 提出, 其模型几何解释见文献[4 ]. 在 MDS 的基础上, INDSCAL 模型通过对 $m$ $n$ $X_i$ $n$
7
2004
... INDSCAL 模型求解问题旨在寻找满足上述约束条件的矩阵集$(Q, D_1, \cdots, D_m)$ $m$ $n \times n$ $X_i (i = 1, \cdots, m)$ [2 ,5 ,6 ] ...
... 其中 $\|\cdot\|$ $D_i$ $m$ $D_i$ [3 ] 提出了基于交替最小二乘法 (Alternating Least Squares, ALS) 的标量算法 CANDECOMP 用于求解原始 INDSCAL 模型. 然而, 即使在 $X_i$ $D_i$ [7 ] . 注意到 (1.2) 式中关于 $Q$ $Q$ $D_i$ $Q$ [2 ,5 ,6 ] 考虑了具有非负显著性权重的一类正交性 INDSCAL 问题 (O-INDSCAL), 即在$Q^T Q = I_p$ $D_i$ [2 ,5 ,6 ] ...
... ,5 ,6 ] ...
... 由于 O-INDSCAL 模型本身的复杂性且变量 $Q$ $D_i$ [5 ,6 ] 将其转化为一类约束可行集下的梯度动力系统, 并设计了基于连续时间的投影梯度流求解算法. 该方法具有全局收敛性且算法易于实现, 同时在多维数据分析中其它矩阵优化模型求解上可推广性强[8 11 ] . 但在处理大规模问题时, 算法效率可能受限. Tendeiro[12 ] 从优化角度研究问题 (1.3) 的一阶和二阶最优化条件. 针对问题 (1.3), Takane[13 ] 给出了近似 ALS 迭代方案, 同时为克服 ALS 方法生成序列收敛较慢的缺点, 将向量序列加速中的极小多项式外推加速 (MPE) 方案应用于该矩阵序列. 数值实验表明, 在数据规模较小的情况下加速效果明显. 文献[14 ] 进一步将向量序列加速中的降秩外推加速 (RRE) 和修正极小多项式外推加速 (MMPE) 以及 Anderson 加速应用于求解问题 (1.3). 2021 年 Trendafilov 和 Gallo[2 ] 从矩阵流形角度系统总结了 MDS 中的若干经典模型, 同时针对 O-INDSCAL 模型给出了基于黎曼优化工具箱 Manopt 的算法框架. ...
... 本节给出数值实验说明结合 $\varepsilon$ - 算法的不动点迭代加速算法应用于求解 O-INDSCAL 问题 (1.3) 的数值效果. 首先给出结合 $\varepsilon$ - 算法的不动点迭代加速算法与原始不动点迭代的数值比较, 进而给出结合 $\varepsilon$ - 算法的不动点迭代加速算法与文献[14 ] 提出的结合向量序列多项式外推加速的不动点迭代加速算法和结合 Anderson 加速的不动点迭代加速算法的数值比较. 同时给出加速算法与问题 (1.3) 求解已有的基于黎曼优化的 Manopt 工具箱求解器[2 ,47 ] 和基于连续时间的投影梯度流算法[5 ,6 ] 的数值比较. 所有的数值结果均通过 Matlab(R2022b), $\text{Intel}^{\circledR}$
... $ \bullet $ 5 ], 按如下方式生成迭代初值$Q^ {(0)}\in \mathcal{O}(n,p)$ $\sum_{i=1}^m X_i$ $p$ $\sum_{i=1}^m X_i\approx P_p\Lambda_p P_p^T$ $\Lambda_p\in \mathbb{R}^{p\times p}$ $p$ $P_p\in \mathbb{R}^{n\times p}$ $Q^{(0)}:=P_p$ . 对于下文中黎曼优化工具箱 Manopt 中算法及投影梯度流算法, 因需用到变量转换$D_i=\tilde{D}_i^2$ $\tilde{D}_i$ $Q^{(0)}$ $D_i^{(0)}$ $\tilde{D} _i^{(0)}$
... 针对 O-INDSCAL 问题 (1.3), Trendafilov[2 ,5 ,6 ] 将其转化为一类约束可行集下的梯度动力系统, 并设计了基于连续时间的投影梯度流求解算法. 更多基于投影梯度流算法求解多维数据分析中其它矩阵优化模型的研究参考文献 [8 11 ]. 本小节给出 ${\tt FPI-VEA}$ ${\tt FPI-TEA}$ ${\tt FPI-STEA}$
The dynamical system approach to multivariate data analysis
6
2006
... INDSCAL 模型求解问题旨在寻找满足上述约束条件的矩阵集$(Q, D_1, \cdots, D_m)$ $m$ $n \times n$ $X_i (i = 1, \cdots, m)$ [2 ,5 ,6 ] ...
... 其中 $\|\cdot\|$ $D_i$ $m$ $D_i$ [3 ] 提出了基于交替最小二乘法 (Alternating Least Squares, ALS) 的标量算法 CANDECOMP 用于求解原始 INDSCAL 模型. 然而, 即使在 $X_i$ $D_i$ [7 ] . 注意到 (1.2) 式中关于 $Q$ $Q$ $D_i$ $Q$ [2 ,5 ,6 ] 考虑了具有非负显著性权重的一类正交性 INDSCAL 问题 (O-INDSCAL), 即在$Q^T Q = I_p$ $D_i$ [2 ,5 ,6 ] ...
... ,6 ] ...
... 由于 O-INDSCAL 模型本身的复杂性且变量 $Q$ $D_i$ [5 ,6 ] 将其转化为一类约束可行集下的梯度动力系统, 并设计了基于连续时间的投影梯度流求解算法. 该方法具有全局收敛性且算法易于实现, 同时在多维数据分析中其它矩阵优化模型求解上可推广性强[8 11 ] . 但在处理大规模问题时, 算法效率可能受限. Tendeiro[12 ] 从优化角度研究问题 (1.3) 的一阶和二阶最优化条件. 针对问题 (1.3), Takane[13 ] 给出了近似 ALS 迭代方案, 同时为克服 ALS 方法生成序列收敛较慢的缺点, 将向量序列加速中的极小多项式外推加速 (MPE) 方案应用于该矩阵序列. 数值实验表明, 在数据规模较小的情况下加速效果明显. 文献[14 ] 进一步将向量序列加速中的降秩外推加速 (RRE) 和修正极小多项式外推加速 (MMPE) 以及 Anderson 加速应用于求解问题 (1.3). 2021 年 Trendafilov 和 Gallo[2 ] 从矩阵流形角度系统总结了 MDS 中的若干经典模型, 同时针对 O-INDSCAL 模型给出了基于黎曼优化工具箱 Manopt 的算法框架. ...
... 本节给出数值实验说明结合 $\varepsilon$ - 算法的不动点迭代加速算法应用于求解 O-INDSCAL 问题 (1.3) 的数值效果. 首先给出结合 $\varepsilon$ - 算法的不动点迭代加速算法与原始不动点迭代的数值比较, 进而给出结合 $\varepsilon$ - 算法的不动点迭代加速算法与文献[14 ] 提出的结合向量序列多项式外推加速的不动点迭代加速算法和结合 Anderson 加速的不动点迭代加速算法的数值比较. 同时给出加速算法与问题 (1.3) 求解已有的基于黎曼优化的 Manopt 工具箱求解器[2 ,47 ] 和基于连续时间的投影梯度流算法[5 ,6 ] 的数值比较. 所有的数值结果均通过 Matlab(R2022b), $\text{Intel}^{\circledR}$
... 针对 O-INDSCAL 问题 (1.3), Trendafilov[2 ,5 ,6 ] 将其转化为一类约束可行集下的梯度动力系统, 并设计了基于连续时间的投影梯度流求解算法. 更多基于投影梯度流算法求解多维数据分析中其它矩阵优化模型的研究参考文献 [8 11 ]. 本小节给出 ${\tt FPI-VEA}$ ${\tt FPI-TEA}$ ${\tt FPI-STEA}$
Explicit CANDECOMP/PARAFAC solutions for a contrived 2 $\times$ 2 $\times$ 2 array of rank three
1
1988
... 其中 $\|\cdot\|$ $D_i$ $m$ $D_i$ [3 ] 提出了基于交替最小二乘法 (Alternating Least Squares, ALS) 的标量算法 CANDECOMP 用于求解原始 INDSCAL 模型. 然而, 即使在 $X_i$ $D_i$ [7 ] . 注意到 (1.2) 式中关于 $Q$ $Q$ $D_i$ $Q$ [2 ,5 ,6 ] 考虑了具有非负显著性权重的一类正交性 INDSCAL 问题 (O-INDSCAL), 即在$Q^T Q = I_p$ $D_i$ [2 ,5 ,6 ] ...
GIPSCAL revisited. A projected gradient approach
2
2002
... 由于 O-INDSCAL 模型本身的复杂性且变量 $Q$ $D_i$ [5 ,6 ] 将其转化为一类约束可行集下的梯度动力系统, 并设计了基于连续时间的投影梯度流求解算法. 该方法具有全局收敛性且算法易于实现, 同时在多维数据分析中其它矩阵优化模型求解上可推广性强[8 11 ] . 但在处理大规模问题时, 算法效率可能受限. Tendeiro[12 ] 从优化角度研究问题 (1.3) 的一阶和二阶最优化条件. 针对问题 (1.3), Takane[13 ] 给出了近似 ALS 迭代方案, 同时为克服 ALS 方法生成序列收敛较慢的缺点, 将向量序列加速中的极小多项式外推加速 (MPE) 方案应用于该矩阵序列. 数值实验表明, 在数据规模较小的情况下加速效果明显. 文献[14 ] 进一步将向量序列加速中的降秩外推加速 (RRE) 和修正极小多项式外推加速 (MMPE) 以及 Anderson 加速应用于求解问题 (1.3). 2021 年 Trendafilov 和 Gallo[2 ] 从矩阵流形角度系统总结了 MDS 中的若干经典模型, 同时针对 O-INDSCAL 模型给出了基于黎曼优化工具箱 Manopt 的算法框架. ...
... 针对 O-INDSCAL 问题 (1.3), Trendafilov[2 ,5 ,6 ] 将其转化为一类约束可行集下的梯度动力系统, 并设计了基于连续时间的投影梯度流求解算法. 更多基于投影梯度流算法求解多维数据分析中其它矩阵优化模型的研究参考文献 [8 11 ]. 本小节给出 ${\tt FPI-VEA}$ ${\tt FPI-TEA}$ ${\tt FPI-STEA}$
Dynamical system approach to factor analysis parameter estimation
0
2003
Projected gradient approach to the numerical solution of the SCoTLASS
0
2006
DINDSCAL: direct INDSCAL
2
2012
... 由于 O-INDSCAL 模型本身的复杂性且变量 $Q$ $D_i$ [5 ,6 ] 将其转化为一类约束可行集下的梯度动力系统, 并设计了基于连续时间的投影梯度流求解算法. 该方法具有全局收敛性且算法易于实现, 同时在多维数据分析中其它矩阵优化模型求解上可推广性强[8 11 ] . 但在处理大规模问题时, 算法效率可能受限. Tendeiro[12 ] 从优化角度研究问题 (1.3) 的一阶和二阶最优化条件. 针对问题 (1.3), Takane[13 ] 给出了近似 ALS 迭代方案, 同时为克服 ALS 方法生成序列收敛较慢的缺点, 将向量序列加速中的极小多项式外推加速 (MPE) 方案应用于该矩阵序列. 数值实验表明, 在数据规模较小的情况下加速效果明显. 文献[14 ] 进一步将向量序列加速中的降秩外推加速 (RRE) 和修正极小多项式外推加速 (MMPE) 以及 Anderson 加速应用于求解问题 (1.3). 2021 年 Trendafilov 和 Gallo[2 ] 从矩阵流形角度系统总结了 MDS 中的若干经典模型, 同时针对 O-INDSCAL 模型给出了基于黎曼优化工具箱 Manopt 的算法框架. ...
... 针对 O-INDSCAL 问题 (1.3), Trendafilov[2 ,5 ,6 ] 将其转化为一类约束可行集下的梯度动力系统, 并设计了基于连续时间的投影梯度流求解算法. 更多基于投影梯度流算法求解多维数据分析中其它矩阵优化模型的研究参考文献 [8 11 ]. 本小节给出 ${\tt FPI-VEA}$ ${\tt FPI-TEA}$ ${\tt FPI-STEA}$
First and second-order derivatives for CP and INDSCAL
2
2011
... 由于 O-INDSCAL 模型本身的复杂性且变量 $Q$ $D_i$ [5 ,6 ] 将其转化为一类约束可行集下的梯度动力系统, 并设计了基于连续时间的投影梯度流求解算法. 该方法具有全局收敛性且算法易于实现, 同时在多维数据分析中其它矩阵优化模型求解上可推广性强[8 11 ] . 但在处理大规模问题时, 算法效率可能受限. Tendeiro[12 ] 从优化角度研究问题 (1.3) 的一阶和二阶最优化条件. 针对问题 (1.3), Takane[13 ] 给出了近似 ALS 迭代方案, 同时为克服 ALS 方法生成序列收敛较慢的缺点, 将向量序列加速中的极小多项式外推加速 (MPE) 方案应用于该矩阵序列. 数值实验表明, 在数据规模较小的情况下加速效果明显. 文献[14 ] 进一步将向量序列加速中的降秩外推加速 (RRE) 和修正极小多项式外推加速 (MMPE) 以及 Anderson 加速应用于求解问题 (1.3). 2021 年 Trendafilov 和 Gallo[2 ] 从矩阵流形角度系统总结了 MDS 中的若干经典模型, 同时针对 O-INDSCAL 模型给出了基于黎曼优化工具箱 Manopt 的算法框架. ...
... 注 3.3 对于算法 5 的终止标准, 结合问题 (1.3) 的一阶最优性条件[12 ] , 同时注意到$\mathcal{O}(n,p)$ $\mathbb{R} ^{n\times p}$ [46 ] 以及$\Omega_{+}(p)$
An acceleration method for Ten Berge et al.'s algorithm for orthogonal INDSCAL
6
2010
... 由于 O-INDSCAL 模型本身的复杂性且变量 $Q$ $D_i$ [5 ,6 ] 将其转化为一类约束可行集下的梯度动力系统, 并设计了基于连续时间的投影梯度流求解算法. 该方法具有全局收敛性且算法易于实现, 同时在多维数据分析中其它矩阵优化模型求解上可推广性强[8 11 ] . 但在处理大规模问题时, 算法效率可能受限. Tendeiro[12 ] 从优化角度研究问题 (1.3) 的一阶和二阶最优化条件. 针对问题 (1.3), Takane[13 ] 给出了近似 ALS 迭代方案, 同时为克服 ALS 方法生成序列收敛较慢的缺点, 将向量序列加速中的极小多项式外推加速 (MPE) 方案应用于该矩阵序列. 数值实验表明, 在数据规模较小的情况下加速效果明显. 文献[14 ] 进一步将向量序列加速中的降秩外推加速 (RRE) 和修正极小多项式外推加速 (MMPE) 以及 Anderson 加速应用于求解问题 (1.3). 2021 年 Trendafilov 和 Gallo[2 ] 从矩阵流形角度系统总结了 MDS 中的若干经典模型, 同时针对 O-INDSCAL 模型给出了基于黎曼优化工具箱 Manopt 的算法框架. ...
... 本文在文献 [13 ,14 ] 基础上, 进一步考虑将向量序列加速中的经典[15 20 ] 应用于求解 O-INDSCAL 模型问题 (1.3). 值得说明的是, 文献[13 ,14 ]采用的向量序列多项式外推加速算法和 Anderson 加速应用于求解问题 (1.3) 时, 因所涉及的原始序列为矩阵序列, 通常需要用到矩阵拉直和反拉直算子, 即先通过拉直算子将矩阵序列转化为向量序列, 执行向量序列加速, 再通过反拉直算子得到矩阵外推加速迭代更新点. 另一方面, 执行向量序列多项式外推加速算法或 Anderson 加速算法时通常需要涉及矩阵分解求解相应子问题, 如执行 MPE, RRE 或 Anderson 加速时,需通过 QR 分解求解相应最小二乘问题, 执行 MMPE 时需用到列选主元的 LU 分解求解相应最小二乘问题. 与多项式外推加速算法或 Anderson 加速算法相比, $\varepsilon$ - 加速算法的优势在于不需要涉及到矩阵分解求解相应子问题, 同时拓扑 $\varepsilon$ - 算法与简化版拓扑 $\varepsilon$ - 算法可直接适用于矩阵序列或张量序列的收敛加速. $\varepsilon$ - 加速算法, 尤其是简化版拓扑 $\varepsilon$ - 算法, 由于其实现的简易性逐渐得到了数值分析领域研究学者的广泛关注[21 26 ], 同时在实际问题中数值表现优异, 如图像处理和图像复原[27 ] , 矩阵完全化问题[28 ] 和多线性 PageRank 计算[29 ] 等. 本文将文献[19 ,20 ] 中提出的向量 $\varepsilon$ - 算法 (VEA)、拓扑 $\varepsilon$ - 算法 (TEA) 以及简化版拓扑 $\varepsilon$ - 算法 (STEA) 应用于求解 O-INDSCAL 问题 (1.3). 首先给出求解问题 (1.3) 的不动点迭代框架, 进而利用 VEA, TEA 和 STEA 对不动点迭代原始生成矩阵序列进行收敛加速. 较充分的数值实验表明, 相较于原始不动点迭代生成矩阵序列, 结合 $\varepsilon$ - 算法的不动点迭代加速算法加速效果较为显著. 此外, 与 O-INDSCAL 问题 (1.3) 现有求解算法相比, 如基于连续时间的投影梯度流求解算法和基于黎曼优化的 Manopt 工具箱求解器, 不动点迭代加速算法在迭代效率上具有较为明显的优势. ...
... 应用于求解 O-INDSCAL 模型问题 (1.3). 值得说明的是, 文献[13 ,14 ]采用的向量序列多项式外推加速算法和 Anderson 加速应用于求解问题 (1.3) 时, 因所涉及的原始序列为矩阵序列, 通常需要用到矩阵拉直和反拉直算子, 即先通过拉直算子将矩阵序列转化为向量序列, 执行向量序列加速, 再通过反拉直算子得到矩阵外推加速迭代更新点. 另一方面, 执行向量序列多项式外推加速算法或 Anderson 加速算法时通常需要涉及矩阵分解求解相应子问题, 如执行 MPE, RRE 或 Anderson 加速时,需通过 QR 分解求解相应最小二乘问题, 执行 MMPE 时需用到列选主元的 LU 分解求解相应最小二乘问题. 与多项式外推加速算法或 Anderson 加速算法相比, $\varepsilon$ - 加速算法的优势在于不需要涉及到矩阵分解求解相应子问题, 同时拓扑 $\varepsilon$ - 算法与简化版拓扑 $\varepsilon$ - 算法可直接适用于矩阵序列或张量序列的收敛加速. $\varepsilon$ - 加速算法, 尤其是简化版拓扑 $\varepsilon$ - 算法, 由于其实现的简易性逐渐得到了数值分析领域研究学者的广泛关注[21 26 ], 同时在实际问题中数值表现优异, 如图像处理和图像复原[27 ] , 矩阵完全化问题[28 ] 和多线性 PageRank 计算[29 ] 等. 本文将文献[19 ,20 ] 中提出的向量 $\varepsilon$ - 算法 (VEA)、拓扑 $\varepsilon$ - 算法 (TEA) 以及简化版拓扑 $\varepsilon$ - 算法 (STEA) 应用于求解 O-INDSCAL 问题 (1.3). 首先给出求解问题 (1.3) 的不动点迭代框架, 进而利用 VEA, TEA 和 STEA 对不动点迭代原始生成矩阵序列进行收敛加速. 较充分的数值实验表明, 相较于原始不动点迭代生成矩阵序列, 结合 $\varepsilon$ - 算法的不动点迭代加速算法加速效果较为显著. 此外, 与 O-INDSCAL 问题 (1.3) 现有求解算法相比, 如基于连续时间的投影梯度流求解算法和基于黎曼优化的 Manopt 工具箱求解器, 不动点迭代加速算法在迭代效率上具有较为明显的优势. ...
... 参考文献[13 ,14 ], 本节首先简要回顾求解 O-INDSCAL 问题 (1.3) 的不动点迭代框架, 更多具体细节可参考文献文献 [第 2 节]. 注意到问题 (1.3) 的目标函数$f$ $D_1, \cdots, D_m$
... 显然无法直接从 (2.10) 式中获得 $Q$ $Q$ [13 ,14 ] : (1) 利用当前迭代步$Q^{(j)}$ $G^{(j)}:=\sum_{i=1}^mX_i Q^{(j)}{D}_i^{(j+1)}$ $Q^TQ=I_p$ $(I_n-QQ^T)G^{(j)}=0$ $ Q^{(j+1)}$ . 记$G^{(j)}=U\triangle V^T$ $G^{(j)}\in \mathbb{R}^{n\times p}$ $U\in\mathbb{R}^{n\times p}$ $V\in\mathbb{R}^{p\times p}$ 31 ], 方程$(I_n-QQ^T)G^{(j)}$ $=0$ $Q^TQ=I_p$ $Q$
... $ \bullet $ $m$ $X_i, i=1, \cdots, m$ 13 ] 按如下方式生成: 方式一 (完全随机 (RAND)): 完全随机方式生成$X_i$
多维标度中个体差异标度模型的向量序列加速算法
9
2025
... 由于 O-INDSCAL 模型本身的复杂性且变量 $Q$ $D_i$ [5 ,6 ] 将其转化为一类约束可行集下的梯度动力系统, 并设计了基于连续时间的投影梯度流求解算法. 该方法具有全局收敛性且算法易于实现, 同时在多维数据分析中其它矩阵优化模型求解上可推广性强[8 11 ] . 但在处理大规模问题时, 算法效率可能受限. Tendeiro[12 ] 从优化角度研究问题 (1.3) 的一阶和二阶最优化条件. 针对问题 (1.3), Takane[13 ] 给出了近似 ALS 迭代方案, 同时为克服 ALS 方法生成序列收敛较慢的缺点, 将向量序列加速中的极小多项式外推加速 (MPE) 方案应用于该矩阵序列. 数值实验表明, 在数据规模较小的情况下加速效果明显. 文献[14 ] 进一步将向量序列加速中的降秩外推加速 (RRE) 和修正极小多项式外推加速 (MMPE) 以及 Anderson 加速应用于求解问题 (1.3). 2021 年 Trendafilov 和 Gallo[2 ] 从矩阵流形角度系统总结了 MDS 中的若干经典模型, 同时针对 O-INDSCAL 模型给出了基于黎曼优化工具箱 Manopt 的算法框架. ...
... 本文在文献 [13 ,14 ] 基础上, 进一步考虑将向量序列加速中的经典[15 20 ] 应用于求解 O-INDSCAL 模型问题 (1.3). 值得说明的是, 文献[13 ,14 ]采用的向量序列多项式外推加速算法和 Anderson 加速应用于求解问题 (1.3) 时, 因所涉及的原始序列为矩阵序列, 通常需要用到矩阵拉直和反拉直算子, 即先通过拉直算子将矩阵序列转化为向量序列, 执行向量序列加速, 再通过反拉直算子得到矩阵外推加速迭代更新点. 另一方面, 执行向量序列多项式外推加速算法或 Anderson 加速算法时通常需要涉及矩阵分解求解相应子问题, 如执行 MPE, RRE 或 Anderson 加速时,需通过 QR 分解求解相应最小二乘问题, 执行 MMPE 时需用到列选主元的 LU 分解求解相应最小二乘问题. 与多项式外推加速算法或 Anderson 加速算法相比, $\varepsilon$ - 加速算法的优势在于不需要涉及到矩阵分解求解相应子问题, 同时拓扑 $\varepsilon$ - 算法与简化版拓扑 $\varepsilon$ - 算法可直接适用于矩阵序列或张量序列的收敛加速. $\varepsilon$ - 加速算法, 尤其是简化版拓扑 $\varepsilon$ - 算法, 由于其实现的简易性逐渐得到了数值分析领域研究学者的广泛关注[21 26 ], 同时在实际问题中数值表现优异, 如图像处理和图像复原[27 ] , 矩阵完全化问题[28 ] 和多线性 PageRank 计算[29 ] 等. 本文将文献[19 ,20 ] 中提出的向量 $\varepsilon$ - 算法 (VEA)、拓扑 $\varepsilon$ - 算法 (TEA) 以及简化版拓扑 $\varepsilon$ - 算法 (STEA) 应用于求解 O-INDSCAL 问题 (1.3). 首先给出求解问题 (1.3) 的不动点迭代框架, 进而利用 VEA, TEA 和 STEA 对不动点迭代原始生成矩阵序列进行收敛加速. 较充分的数值实验表明, 相较于原始不动点迭代生成矩阵序列, 结合 $\varepsilon$ - 算法的不动点迭代加速算法加速效果较为显著. 此外, 与 O-INDSCAL 问题 (1.3) 现有求解算法相比, 如基于连续时间的投影梯度流求解算法和基于黎曼优化的 Manopt 工具箱求解器, 不动点迭代加速算法在迭代效率上具有较为明显的优势. ...
... ,14 ]采用的向量序列多项式外推加速算法和 Anderson 加速应用于求解问题 (1.3) 时, 因所涉及的原始序列为矩阵序列, 通常需要用到矩阵拉直和反拉直算子, 即先通过拉直算子将矩阵序列转化为向量序列, 执行向量序列加速, 再通过反拉直算子得到矩阵外推加速迭代更新点. 另一方面, 执行向量序列多项式外推加速算法或 Anderson 加速算法时通常需要涉及矩阵分解求解相应子问题, 如执行 MPE, RRE 或 Anderson 加速时,需通过 QR 分解求解相应最小二乘问题, 执行 MMPE 时需用到列选主元的 LU 分解求解相应最小二乘问题. 与多项式外推加速算法或 Anderson 加速算法相比, $\varepsilon$ - 加速算法的优势在于不需要涉及到矩阵分解求解相应子问题, 同时拓扑 $\varepsilon$ - 算法与简化版拓扑 $\varepsilon$ - 算法可直接适用于矩阵序列或张量序列的收敛加速. $\varepsilon$ - 加速算法, 尤其是简化版拓扑 $\varepsilon$ - 算法, 由于其实现的简易性逐渐得到了数值分析领域研究学者的广泛关注[21 26 ], 同时在实际问题中数值表现优异, 如图像处理和图像复原[27 ] , 矩阵完全化问题[28 ] 和多线性 PageRank 计算[29 ] 等. 本文将文献[19 ,20 ] 中提出的向量 $\varepsilon$ - 算法 (VEA)、拓扑 $\varepsilon$ - 算法 (TEA) 以及简化版拓扑 $\varepsilon$ - 算法 (STEA) 应用于求解 O-INDSCAL 问题 (1.3). 首先给出求解问题 (1.3) 的不动点迭代框架, 进而利用 VEA, TEA 和 STEA 对不动点迭代原始生成矩阵序列进行收敛加速. 较充分的数值实验表明, 相较于原始不动点迭代生成矩阵序列, 结合 $\varepsilon$ - 算法的不动点迭代加速算法加速效果较为显著. 此外, 与 O-INDSCAL 问题 (1.3) 现有求解算法相比, 如基于连续时间的投影梯度流求解算法和基于黎曼优化的 Manopt 工具箱求解器, 不动点迭代加速算法在迭代效率上具有较为明显的优势. ...
... 参考文献[13 ,14 ], 本节首先简要回顾求解 O-INDSCAL 问题 (1.3) 的不动点迭代框架, 更多具体细节可参考文献文献 [第 2 节]. 注意到问题 (1.3) 的目标函数$f$ $D_1, \cdots, D_m$
... 显然无法直接从 (2.10) 式中获得 $Q$ $Q$ [13 ,14 ] : (1) 利用当前迭代步$Q^{(j)}$ $G^{(j)}:=\sum_{i=1}^mX_i Q^{(j)}{D}_i^{(j+1)}$ $Q^TQ=I_p$ $(I_n-QQ^T)G^{(j)}=0$ $ Q^{(j+1)}$ . 记$G^{(j)}=U\triangle V^T$ $G^{(j)}\in \mathbb{R}^{n\times p}$ $U\in\mathbb{R}^{n\times p}$ $V\in\mathbb{R}^{p\times p}$ 31 ], 方程$(I_n-QQ^T)G^{(j)}$ $=0$ $Q^TQ=I_p$ $Q$
... 本节给出数值实验说明结合 $\varepsilon$ - 算法的不动点迭代加速算法应用于求解 O-INDSCAL 问题 (1.3) 的数值效果. 首先给出结合 $\varepsilon$ - 算法的不动点迭代加速算法与原始不动点迭代的数值比较, 进而给出结合 $\varepsilon$ - 算法的不动点迭代加速算法与文献[14 ] 提出的结合向量序列多项式外推加速的不动点迭代加速算法和结合 Anderson 加速的不动点迭代加速算法的数值比较. 同时给出加速算法与问题 (1.3) 求解已有的基于黎曼优化的 Manopt 工具箱求解器[2 ,47 ] 和基于连续时间的投影梯度流算法[5 ,6 ] 的数值比较. 所有的数值结果均通过 Matlab(R2022b), $\text{Intel}^{\circledR}$
... 本小节给出结合 $\varepsilon$ - 算法的不动点迭代加速算法与文献[14 ] 提出的结合向量序列极小多项式外推加速 (记为 ${\tt FPI-MPE}$ ) , 降秩外推加速 (记为 ${\tt FPI-RRE}$ ) , 修正极小多项式外推加速 (记为 ${\tt FPI-MMPE}$ ) 和 Anderson 加速 (记为 ${\tt FPI-Anderson}$ ) 的不动点迭代加速算法的数值比较. 表 6 给出了原始数据 $X_i$ $[n,p]$ $m$ $k$ ${{\tt IT}}$ ${{\tt CPU}}$ ${\tt \mathrm{Error}}$ ${\tt \mathrm{Fvalue}}$ 表 5 . 需要说明的是, 同表 5 , 对于所有加速算法 (Anderson 加速除外), ${{\tt IT}}$ 图 3 给出了原始数据 $X_i$ $k=5$ $\text{log}_{10}\|\operatorname{Error}\|$
... 从表 6 中可以看出, 对于原始数据 $X_i$ ${\tt FPI-MPE}$ ${\tt FPI-RRE}$ ${\tt FPI-MMPE}$ ) 相比, 达到相同的迭代终止精度, $\varepsilon$ - 加速算法 (${\tt FPI-VEA}$ ${\tt FPI-TEA}$ ${\tt FPI-STEA}$ ) 通常需要更多的迭代步和迭代时间, 这是因为对于相同的加速窗口宽度 $k$ $\varepsilon$ - 加速算法需要 $2k+1$ ${\tt FPI-MPE}$ ${\tt FPI-RRE}$ ${\tt FPI-MMPE}$ $k+1$ [14 ,45 ] . 但值得说明的是 ${\tt FPI-TEA}$ ${\tt FPI-STEA}$ $\varepsilon$ - 算法的不动点迭代加速算法与结合多项式外推加速和 Anderson 加速的不动点迭代加速算法相比具有可比较的加速效果. ...
... 其中 $\Omega(p)$ $p$ 14 ,第 4.3 小节], 更多关于基于黎曼优化求解 MDS 中各类矩阵优化模型的文献可参考文献 [48 50 ]. 基于一阶最优性条件, 利用黎曼优化算法求解问题 (4.2) 的终止标准均取为 ...
Vector sequence acceleration algorithms for the INDSCAL model in multidimensional scaling analysis
9
2025
... 由于 O-INDSCAL 模型本身的复杂性且变量 $Q$ $D_i$ [5 ,6 ] 将其转化为一类约束可行集下的梯度动力系统, 并设计了基于连续时间的投影梯度流求解算法. 该方法具有全局收敛性且算法易于实现, 同时在多维数据分析中其它矩阵优化模型求解上可推广性强[8 11 ] . 但在处理大规模问题时, 算法效率可能受限. Tendeiro[12 ] 从优化角度研究问题 (1.3) 的一阶和二阶最优化条件. 针对问题 (1.3), Takane[13 ] 给出了近似 ALS 迭代方案, 同时为克服 ALS 方法生成序列收敛较慢的缺点, 将向量序列加速中的极小多项式外推加速 (MPE) 方案应用于该矩阵序列. 数值实验表明, 在数据规模较小的情况下加速效果明显. 文献[14 ] 进一步将向量序列加速中的降秩外推加速 (RRE) 和修正极小多项式外推加速 (MMPE) 以及 Anderson 加速应用于求解问题 (1.3). 2021 年 Trendafilov 和 Gallo[2 ] 从矩阵流形角度系统总结了 MDS 中的若干经典模型, 同时针对 O-INDSCAL 模型给出了基于黎曼优化工具箱 Manopt 的算法框架. ...
... 本文在文献 [13 ,14 ] 基础上, 进一步考虑将向量序列加速中的经典[15 20 ] 应用于求解 O-INDSCAL 模型问题 (1.3). 值得说明的是, 文献[13 ,14 ]采用的向量序列多项式外推加速算法和 Anderson 加速应用于求解问题 (1.3) 时, 因所涉及的原始序列为矩阵序列, 通常需要用到矩阵拉直和反拉直算子, 即先通过拉直算子将矩阵序列转化为向量序列, 执行向量序列加速, 再通过反拉直算子得到矩阵外推加速迭代更新点. 另一方面, 执行向量序列多项式外推加速算法或 Anderson 加速算法时通常需要涉及矩阵分解求解相应子问题, 如执行 MPE, RRE 或 Anderson 加速时,需通过 QR 分解求解相应最小二乘问题, 执行 MMPE 时需用到列选主元的 LU 分解求解相应最小二乘问题. 与多项式外推加速算法或 Anderson 加速算法相比, $\varepsilon$ - 加速算法的优势在于不需要涉及到矩阵分解求解相应子问题, 同时拓扑 $\varepsilon$ - 算法与简化版拓扑 $\varepsilon$ - 算法可直接适用于矩阵序列或张量序列的收敛加速. $\varepsilon$ - 加速算法, 尤其是简化版拓扑 $\varepsilon$ - 算法, 由于其实现的简易性逐渐得到了数值分析领域研究学者的广泛关注[21 26 ], 同时在实际问题中数值表现优异, 如图像处理和图像复原[27 ] , 矩阵完全化问题[28 ] 和多线性 PageRank 计算[29 ] 等. 本文将文献[19 ,20 ] 中提出的向量 $\varepsilon$ - 算法 (VEA)、拓扑 $\varepsilon$ - 算法 (TEA) 以及简化版拓扑 $\varepsilon$ - 算法 (STEA) 应用于求解 O-INDSCAL 问题 (1.3). 首先给出求解问题 (1.3) 的不动点迭代框架, 进而利用 VEA, TEA 和 STEA 对不动点迭代原始生成矩阵序列进行收敛加速. 较充分的数值实验表明, 相较于原始不动点迭代生成矩阵序列, 结合 $\varepsilon$ - 算法的不动点迭代加速算法加速效果较为显著. 此外, 与 O-INDSCAL 问题 (1.3) 现有求解算法相比, 如基于连续时间的投影梯度流求解算法和基于黎曼优化的 Manopt 工具箱求解器, 不动点迭代加速算法在迭代效率上具有较为明显的优势. ...
... ,14 ]采用的向量序列多项式外推加速算法和 Anderson 加速应用于求解问题 (1.3) 时, 因所涉及的原始序列为矩阵序列, 通常需要用到矩阵拉直和反拉直算子, 即先通过拉直算子将矩阵序列转化为向量序列, 执行向量序列加速, 再通过反拉直算子得到矩阵外推加速迭代更新点. 另一方面, 执行向量序列多项式外推加速算法或 Anderson 加速算法时通常需要涉及矩阵分解求解相应子问题, 如执行 MPE, RRE 或 Anderson 加速时,需通过 QR 分解求解相应最小二乘问题, 执行 MMPE 时需用到列选主元的 LU 分解求解相应最小二乘问题. 与多项式外推加速算法或 Anderson 加速算法相比, $\varepsilon$ - 加速算法的优势在于不需要涉及到矩阵分解求解相应子问题, 同时拓扑 $\varepsilon$ - 算法与简化版拓扑 $\varepsilon$ - 算法可直接适用于矩阵序列或张量序列的收敛加速. $\varepsilon$ - 加速算法, 尤其是简化版拓扑 $\varepsilon$ - 算法, 由于其实现的简易性逐渐得到了数值分析领域研究学者的广泛关注[21 26 ], 同时在实际问题中数值表现优异, 如图像处理和图像复原[27 ] , 矩阵完全化问题[28 ] 和多线性 PageRank 计算[29 ] 等. 本文将文献[19 ,20 ] 中提出的向量 $\varepsilon$ - 算法 (VEA)、拓扑 $\varepsilon$ - 算法 (TEA) 以及简化版拓扑 $\varepsilon$ - 算法 (STEA) 应用于求解 O-INDSCAL 问题 (1.3). 首先给出求解问题 (1.3) 的不动点迭代框架, 进而利用 VEA, TEA 和 STEA 对不动点迭代原始生成矩阵序列进行收敛加速. 较充分的数值实验表明, 相较于原始不动点迭代生成矩阵序列, 结合 $\varepsilon$ - 算法的不动点迭代加速算法加速效果较为显著. 此外, 与 O-INDSCAL 问题 (1.3) 现有求解算法相比, 如基于连续时间的投影梯度流求解算法和基于黎曼优化的 Manopt 工具箱求解器, 不动点迭代加速算法在迭代效率上具有较为明显的优势. ...
... 参考文献[13 ,14 ], 本节首先简要回顾求解 O-INDSCAL 问题 (1.3) 的不动点迭代框架, 更多具体细节可参考文献文献 [第 2 节]. 注意到问题 (1.3) 的目标函数$f$ $D_1, \cdots, D_m$
... 显然无法直接从 (2.10) 式中获得 $Q$ $Q$ [13 ,14 ] : (1) 利用当前迭代步$Q^{(j)}$ $G^{(j)}:=\sum_{i=1}^mX_i Q^{(j)}{D}_i^{(j+1)}$ $Q^TQ=I_p$ $(I_n-QQ^T)G^{(j)}=0$ $ Q^{(j+1)}$ . 记$G^{(j)}=U\triangle V^T$ $G^{(j)}\in \mathbb{R}^{n\times p}$ $U\in\mathbb{R}^{n\times p}$ $V\in\mathbb{R}^{p\times p}$ 31 ], 方程$(I_n-QQ^T)G^{(j)}$ $=0$ $Q^TQ=I_p$ $Q$
... 本节给出数值实验说明结合 $\varepsilon$ - 算法的不动点迭代加速算法应用于求解 O-INDSCAL 问题 (1.3) 的数值效果. 首先给出结合 $\varepsilon$ - 算法的不动点迭代加速算法与原始不动点迭代的数值比较, 进而给出结合 $\varepsilon$ - 算法的不动点迭代加速算法与文献[14 ] 提出的结合向量序列多项式外推加速的不动点迭代加速算法和结合 Anderson 加速的不动点迭代加速算法的数值比较. 同时给出加速算法与问题 (1.3) 求解已有的基于黎曼优化的 Manopt 工具箱求解器[2 ,47 ] 和基于连续时间的投影梯度流算法[5 ,6 ] 的数值比较. 所有的数值结果均通过 Matlab(R2022b), $\text{Intel}^{\circledR}$
... 本小节给出结合 $\varepsilon$ - 算法的不动点迭代加速算法与文献[14 ] 提出的结合向量序列极小多项式外推加速 (记为 ${\tt FPI-MPE}$ ) , 降秩外推加速 (记为 ${\tt FPI-RRE}$ ) , 修正极小多项式外推加速 (记为 ${\tt FPI-MMPE}$ ) 和 Anderson 加速 (记为 ${\tt FPI-Anderson}$ ) 的不动点迭代加速算法的数值比较. 表 6 给出了原始数据 $X_i$ $[n,p]$ $m$ $k$ ${{\tt IT}}$ ${{\tt CPU}}$ ${\tt \mathrm{Error}}$ ${\tt \mathrm{Fvalue}}$ 表 5 . 需要说明的是, 同表 5 , 对于所有加速算法 (Anderson 加速除外), ${{\tt IT}}$ 图 3 给出了原始数据 $X_i$ $k=5$ $\text{log}_{10}\|\operatorname{Error}\|$
... 从表 6 中可以看出, 对于原始数据 $X_i$ ${\tt FPI-MPE}$ ${\tt FPI-RRE}$ ${\tt FPI-MMPE}$ ) 相比, 达到相同的迭代终止精度, $\varepsilon$ - 加速算法 (${\tt FPI-VEA}$ ${\tt FPI-TEA}$ ${\tt FPI-STEA}$ ) 通常需要更多的迭代步和迭代时间, 这是因为对于相同的加速窗口宽度 $k$ $\varepsilon$ - 加速算法需要 $2k+1$ ${\tt FPI-MPE}$ ${\tt FPI-RRE}$ ${\tt FPI-MMPE}$ $k+1$ [14 ,45 ] . 但值得说明的是 ${\tt FPI-TEA}$ ${\tt FPI-STEA}$ $\varepsilon$ - 算法的不动点迭代加速算法与结合多项式外推加速和 Anderson 加速的不动点迭代加速算法相比具有可比较的加速效果. ...
... 其中 $\Omega(p)$ $p$ 14 ,第 4.3 小节], 更多关于基于黎曼优化求解 MDS 中各类矩阵优化模型的文献可参考文献 [48 50 ]. 基于一阶最优性条件, 利用黎曼优化算法求解问题 (4.2) 的终止标准均取为 ...
Non-linear transformations of divergent and slowly convergent sequences
2
1955
... 本文在文献 [13 ,14 ] 基础上, 进一步考虑将向量序列加速中的经典[15 20 ] 应用于求解 O-INDSCAL 模型问题 (1.3). 值得说明的是, 文献[13 ,14 ]采用的向量序列多项式外推加速算法和 Anderson 加速应用于求解问题 (1.3) 时, 因所涉及的原始序列为矩阵序列, 通常需要用到矩阵拉直和反拉直算子, 即先通过拉直算子将矩阵序列转化为向量序列, 执行向量序列加速, 再通过反拉直算子得到矩阵外推加速迭代更新点. 另一方面, 执行向量序列多项式外推加速算法或 Anderson 加速算法时通常需要涉及矩阵分解求解相应子问题, 如执行 MPE, RRE 或 Anderson 加速时,需通过 QR 分解求解相应最小二乘问题, 执行 MMPE 时需用到列选主元的 LU 分解求解相应最小二乘问题. 与多项式外推加速算法或 Anderson 加速算法相比, $\varepsilon$ - 加速算法的优势在于不需要涉及到矩阵分解求解相应子问题, 同时拓扑 $\varepsilon$ - 算法与简化版拓扑 $\varepsilon$ - 算法可直接适用于矩阵序列或张量序列的收敛加速. $\varepsilon$ - 加速算法, 尤其是简化版拓扑 $\varepsilon$ - 算法, 由于其实现的简易性逐渐得到了数值分析领域研究学者的广泛关注[21 26 ], 同时在实际问题中数值表现优异, 如图像处理和图像复原[27 ] , 矩阵完全化问题[28 ] 和多线性 PageRank 计算[29 ] 等. 本文将文献[19 ,20 ] 中提出的向量 $\varepsilon$ - 算法 (VEA)、拓扑 $\varepsilon$ - 算法 (TEA) 以及简化版拓扑 $\varepsilon$ - 算法 (STEA) 应用于求解 O-INDSCAL 问题 (1.3). 首先给出求解问题 (1.3) 的不动点迭代框架, 进而利用 VEA, TEA 和 STEA 对不动点迭代原始生成矩阵序列进行收敛加速. 较充分的数值实验表明, 相较于原始不动点迭代生成矩阵序列, 结合 $\varepsilon$ - 算法的不动点迭代加速算法加速效果较为显著. 此外, 与 O-INDSCAL 问题 (1.3) 现有求解算法相比, 如基于连续时间的投影梯度流求解算法和基于黎曼优化的 Manopt 工具箱求解器, 不动点迭代加速算法在迭代效率上具有较为明显的优势. ...
... 提高迭代序列 (标量, 向量, 矩阵或张量序列等) 的收敛速度在科学与工程计算及机器学习等领域具有重要意义[32 39 ] , 也是当今计算数学领域的研究热点课题之一[40 43 ] . 对于收敛较慢的序列, 通常采用合适的加速算法加速其收敛. 通过序列变换调整其生成过程, 将原序列转变为新序列, 在特定条件下, 新序列能够更快收敛至相同的极限. 对于标量数列, 最著名的变换之一是标量 Shanks 变换[15 ] , 它可以通过 Wynn 的标量 $\varepsilon$ - 算法逐步递归实现[16 ] . Wynn[17 ] 同时扩展了该变换, 使其适用于向量序列. 但向量 $\varepsilon$ - 算法的代数理论无法直接从标量 Shanks 变换的规则中推导出来. 为弥补这一不足, Brezinski[18 ] 引入了拓扑 Shanks 变换, 并通过两种拓扑 $\varepsilon$ - 算法 (TEA1 和 TEA2) 将其推广至任意向量空间中的向量序列, 从而实现了该算法的扩展. 近年来, TEA1 和 TEA2 的规则得到了简化, 衍生出两类简化版拓扑 $\varepsilon$ - 算法 (STEA1 和 STEA2)[19 ] , 相关的软件应用见文献[20 ]. 这两种简化版拓扑 $\varepsilon$ - 算法通过减少向量的使用显著降低了存储需求, 并提高了算法的数值稳定性. ...
On a device for computing the $e_m (S_n)$ transformation
3
1956
... 提高迭代序列 (标量, 向量, 矩阵或张量序列等) 的收敛速度在科学与工程计算及机器学习等领域具有重要意义[32 39 ] , 也是当今计算数学领域的研究热点课题之一[40 43 ] . 对于收敛较慢的序列, 通常采用合适的加速算法加速其收敛. 通过序列变换调整其生成过程, 将原序列转变为新序列, 在特定条件下, 新序列能够更快收敛至相同的极限. 对于标量数列, 最著名的变换之一是标量 Shanks 变换[15 ] , 它可以通过 Wynn 的标量 $\varepsilon$ - 算法逐步递归实现[16 ] . Wynn[17 ] 同时扩展了该变换, 使其适用于向量序列. 但向量 $\varepsilon$ - 算法的代数理论无法直接从标量 Shanks 变换的规则中推导出来. 为弥补这一不足, Brezinski[18 ] 引入了拓扑 Shanks 变换, 并通过两种拓扑 $\varepsilon$ - 算法 (TEA1 和 TEA2) 将其推广至任意向量空间中的向量序列, 从而实现了该算法的扩展. 近年来, TEA1 和 TEA2 的规则得到了简化, 衍生出两类简化版拓扑 $\varepsilon$ - 算法 (STEA1 和 STEA2)[19 ] , 相关的软件应用见文献[20 ]. 这两种简化版拓扑 $\varepsilon$ - 算法通过减少向量的使用显著降低了存储需求, 并提高了算法的数值稳定性. ...
... 为避免计算 (3.7) 式中的行列式, Wynn[16 ] 提出了一类只需简单递归的标量 $\varepsilon$ - 算法 (SEA) 用于实现 Shanks 变换, 其计算规则如下 ...
... (3.8) 式中 $\varepsilon_k^{(n)}$ 表1 所示, 称为$\varepsilon$ $\{\varepsilon_k^{(n)}\}_{n=0}^{\infty}$ $k$ $\{\varepsilon_k^{(n)}\}_{k=0}^{\infty}$ $n$ [16 ] 同时给出了如下重要结果建立了标量 Shanks 变换与标量 $\varepsilon$ - 算法之间的联系 ...
Acceleration techniques for iterated vector and matrix problems
3
1962
... 提高迭代序列 (标量, 向量, 矩阵或张量序列等) 的收敛速度在科学与工程计算及机器学习等领域具有重要意义[32 39 ] , 也是当今计算数学领域的研究热点课题之一[40 43 ] . 对于收敛较慢的序列, 通常采用合适的加速算法加速其收敛. 通过序列变换调整其生成过程, 将原序列转变为新序列, 在特定条件下, 新序列能够更快收敛至相同的极限. 对于标量数列, 最著名的变换之一是标量 Shanks 变换[15 ] , 它可以通过 Wynn 的标量 $\varepsilon$ - 算法逐步递归实现[16 ] . Wynn[17 ] 同时扩展了该变换, 使其适用于向量序列. 但向量 $\varepsilon$ - 算法的代数理论无法直接从标量 Shanks 变换的规则中推导出来. 为弥补这一不足, Brezinski[18 ] 引入了拓扑 Shanks 变换, 并通过两种拓扑 $\varepsilon$ - 算法 (TEA1 和 TEA2) 将其推广至任意向量空间中的向量序列, 从而实现了该算法的扩展. 近年来, TEA1 和 TEA2 的规则得到了简化, 衍生出两类简化版拓扑 $\varepsilon$ - 算法 (STEA1 和 STEA2)[19 ] , 相关的软件应用见文献[20 ]. 这两种简化版拓扑 $\varepsilon$ - 算法通过减少向量的使用显著降低了存储需求, 并提高了算法的数值稳定性. ...
... 为论文完整性, 本节在文献[17 20 ] 的基础上, 细致阐述 $\varepsilon$ - 加速算法的理论基础, 加速原理及具体实施方案, 进而结合上一节所构建的的不动点迭代框架 (2.12), 设计求解 O-INDSCAL 问题 (1.3) 基于 $\varepsilon$ - 算法的不动点迭代加速算法. ...
... 其中$(\cdot, \cdot)$ $E$ [17 ] 进一步将标量$\varepsilon$ - 算法 " 矢量化", 推广应用到向量空间$E=\mathbb{R}^m$ $\{S_n\}$ $\varepsilon$ - 算法 (VEA), 其递归规则同(3.8) 式. 然而 Shanks 变换无法直接推广到向量空间. 为了克服这一局限, Brezinski[18 ] 通过引入向量空间的代数对偶空间$E^*$ $\mathbf{y} \in E^*$ $\langle\cdot, \cdot\rangle$
3
2013
... 提高迭代序列 (标量, 向量, 矩阵或张量序列等) 的收敛速度在科学与工程计算及机器学习等领域具有重要意义[32 39 ] , 也是当今计算数学领域的研究热点课题之一[40 43 ] . 对于收敛较慢的序列, 通常采用合适的加速算法加速其收敛. 通过序列变换调整其生成过程, 将原序列转变为新序列, 在特定条件下, 新序列能够更快收敛至相同的极限. 对于标量数列, 最著名的变换之一是标量 Shanks 变换[15 ] , 它可以通过 Wynn 的标量 $\varepsilon$ - 算法逐步递归实现[16 ] . Wynn[17 ] 同时扩展了该变换, 使其适用于向量序列. 但向量 $\varepsilon$ - 算法的代数理论无法直接从标量 Shanks 变换的规则中推导出来. 为弥补这一不足, Brezinski[18 ] 引入了拓扑 Shanks 变换, 并通过两种拓扑 $\varepsilon$ - 算法 (TEA1 和 TEA2) 将其推广至任意向量空间中的向量序列, 从而实现了该算法的扩展. 近年来, TEA1 和 TEA2 的规则得到了简化, 衍生出两类简化版拓扑 $\varepsilon$ - 算法 (STEA1 和 STEA2)[19 ] , 相关的软件应用见文献[20 ]. 这两种简化版拓扑 $\varepsilon$ - 算法通过减少向量的使用显著降低了存储需求, 并提高了算法的数值稳定性. ...
... 新的序列$\{T_n\}$ $\{S_n\}$ $\varepsilon$ - 变换、Levin 变换、Shanks 变换、$\rho$ $\theta$ $\eta$ [18 ,44 ] . Shanks 变换假定序列满足如下关系式[20 ,40 ] ...
... 其中$(\cdot, \cdot)$ $E$ [17 ] 进一步将标量$\varepsilon$ - 算法 " 矢量化", 推广应用到向量空间$E=\mathbb{R}^m$ $\{S_n\}$ $\varepsilon$ - 算法 (VEA), 其递归规则同(3.8) 式. 然而 Shanks 变换无法直接推广到向量空间. 为了克服这一局限, Brezinski[18 ] 通过引入向量空间的代数对偶空间$E^*$ $\mathbf{y} \in E^*$ $\langle\cdot, \cdot\rangle$
The simplified topological $\varepsilon$ -algorithms for accelerating sequences in a vector space
4
2014
... 本文在文献 [13 ,14 ] 基础上, 进一步考虑将向量序列加速中的经典[15 20 ] 应用于求解 O-INDSCAL 模型问题 (1.3). 值得说明的是, 文献[13 ,14 ]采用的向量序列多项式外推加速算法和 Anderson 加速应用于求解问题 (1.3) 时, 因所涉及的原始序列为矩阵序列, 通常需要用到矩阵拉直和反拉直算子, 即先通过拉直算子将矩阵序列转化为向量序列, 执行向量序列加速, 再通过反拉直算子得到矩阵外推加速迭代更新点. 另一方面, 执行向量序列多项式外推加速算法或 Anderson 加速算法时通常需要涉及矩阵分解求解相应子问题, 如执行 MPE, RRE 或 Anderson 加速时,需通过 QR 分解求解相应最小二乘问题, 执行 MMPE 时需用到列选主元的 LU 分解求解相应最小二乘问题. 与多项式外推加速算法或 Anderson 加速算法相比, $\varepsilon$ - 加速算法的优势在于不需要涉及到矩阵分解求解相应子问题, 同时拓扑 $\varepsilon$ - 算法与简化版拓扑 $\varepsilon$ - 算法可直接适用于矩阵序列或张量序列的收敛加速. $\varepsilon$ - 加速算法, 尤其是简化版拓扑 $\varepsilon$ - 算法, 由于其实现的简易性逐渐得到了数值分析领域研究学者的广泛关注[21 26 ], 同时在实际问题中数值表现优异, 如图像处理和图像复原[27 ] , 矩阵完全化问题[28 ] 和多线性 PageRank 计算[29 ] 等. 本文将文献[19 ,20 ] 中提出的向量 $\varepsilon$ - 算法 (VEA)、拓扑 $\varepsilon$ - 算法 (TEA) 以及简化版拓扑 $\varepsilon$ - 算法 (STEA) 应用于求解 O-INDSCAL 问题 (1.3). 首先给出求解问题 (1.3) 的不动点迭代框架, 进而利用 VEA, TEA 和 STEA 对不动点迭代原始生成矩阵序列进行收敛加速. 较充分的数值实验表明, 相较于原始不动点迭代生成矩阵序列, 结合 $\varepsilon$ - 算法的不动点迭代加速算法加速效果较为显著. 此外, 与 O-INDSCAL 问题 (1.3) 现有求解算法相比, 如基于连续时间的投影梯度流求解算法和基于黎曼优化的 Manopt 工具箱求解器, 不动点迭代加速算法在迭代效率上具有较为明显的优势. ...
... 提高迭代序列 (标量, 向量, 矩阵或张量序列等) 的收敛速度在科学与工程计算及机器学习等领域具有重要意义[32 39 ] , 也是当今计算数学领域的研究热点课题之一[40 43 ] . 对于收敛较慢的序列, 通常采用合适的加速算法加速其收敛. 通过序列变换调整其生成过程, 将原序列转变为新序列, 在特定条件下, 新序列能够更快收敛至相同的极限. 对于标量数列, 最著名的变换之一是标量 Shanks 变换[15 ] , 它可以通过 Wynn 的标量 $\varepsilon$ - 算法逐步递归实现[16 ] . Wynn[17 ] 同时扩展了该变换, 使其适用于向量序列. 但向量 $\varepsilon$ - 算法的代数理论无法直接从标量 Shanks 变换的规则中推导出来. 为弥补这一不足, Brezinski[18 ] 引入了拓扑 Shanks 变换, 并通过两种拓扑 $\varepsilon$ - 算法 (TEA1 和 TEA2) 将其推广至任意向量空间中的向量序列, 从而实现了该算法的扩展. 近年来, TEA1 和 TEA2 的规则得到了简化, 衍生出两类简化版拓扑 $\varepsilon$ - 算法 (STEA1 和 STEA2)[19 ] , 相关的软件应用见文献[20 ]. 这两种简化版拓扑 $\varepsilon$ - 算法通过减少向量的使用显著降低了存储需求, 并提高了算法的数值稳定性. ...
... 为了实现 $\varepsilon$ - 算法 (SEA, VEA, TEA 和 STEA) 并构造 $\varepsilon$ - 数表, 最直接的方法是存储所有 $k$ $n$ $\varepsilon$ - 数表的三角形部分. 然而, 这样的方法需要存储整个三角形部分的所有元素, 对于向量序列或矩阵序列而言, 可能会导致较高的存储开销. 为了避免存储整个三角形数表, 一种更高效的方法是逐步计算原始序列的每一项, 并按升序对角线的顺序计算 $\varepsilon$ - 数表[19 ,20 ] . 在生成 $\varepsilon$ - 数表的一个三角形部分并仅存储了其最后一行升序对角线后, 引入初始序列 $\{S_n\}$ $(e_i)$
... 注 3.1 SEA、VEA、TEA 及 STEA 在执行过程中, 不涉及任何矩阵分解, 也不需要求解相关子问题, 这是 $\varepsilon$ - 加速算法区别于向量序列多项式外推加速 (如 MPE, MMPE 和 RRE 等) 和 Anderson 加速算法的优势所在. 关于 $E$ $E^*$ $\mathbf{y}$ 19 ,20 ]给出了常用的选取方式. 若原始序列为向量序列$\{S_n\}\subset \mathbb{R}^m$ $\{S_n\}\subset \mathbb{R}^{m\times n}$ $\mathbb{R}^m$ $\mathbb{R}^{m\times n}$
The simplified topological $\varepsilon$ -algorithms: software and applications
17
2017
... 本文在文献 [13 ,14 ] 基础上, 进一步考虑将向量序列加速中的经典[15 20 ] 应用于求解 O-INDSCAL 模型问题 (1.3). 值得说明的是, 文献[13 ,14 ]采用的向量序列多项式外推加速算法和 Anderson 加速应用于求解问题 (1.3) 时, 因所涉及的原始序列为矩阵序列, 通常需要用到矩阵拉直和反拉直算子, 即先通过拉直算子将矩阵序列转化为向量序列, 执行向量序列加速, 再通过反拉直算子得到矩阵外推加速迭代更新点. 另一方面, 执行向量序列多项式外推加速算法或 Anderson 加速算法时通常需要涉及矩阵分解求解相应子问题, 如执行 MPE, RRE 或 Anderson 加速时,需通过 QR 分解求解相应最小二乘问题, 执行 MMPE 时需用到列选主元的 LU 分解求解相应最小二乘问题. 与多项式外推加速算法或 Anderson 加速算法相比, $\varepsilon$ - 加速算法的优势在于不需要涉及到矩阵分解求解相应子问题, 同时拓扑 $\varepsilon$ - 算法与简化版拓扑 $\varepsilon$ - 算法可直接适用于矩阵序列或张量序列的收敛加速. $\varepsilon$ - 加速算法, 尤其是简化版拓扑 $\varepsilon$ - 算法, 由于其实现的简易性逐渐得到了数值分析领域研究学者的广泛关注[21 26 ], 同时在实际问题中数值表现优异, 如图像处理和图像复原[27 ] , 矩阵完全化问题[28 ] 和多线性 PageRank 计算[29 ] 等. 本文将文献[19 ,20 ] 中提出的向量 $\varepsilon$ - 算法 (VEA)、拓扑 $\varepsilon$ - 算法 (TEA) 以及简化版拓扑 $\varepsilon$ - 算法 (STEA) 应用于求解 O-INDSCAL 问题 (1.3). 首先给出求解问题 (1.3) 的不动点迭代框架, 进而利用 VEA, TEA 和 STEA 对不动点迭代原始生成矩阵序列进行收敛加速. 较充分的数值实验表明, 相较于原始不动点迭代生成矩阵序列, 结合 $\varepsilon$ - 算法的不动点迭代加速算法加速效果较为显著. 此外, 与 O-INDSCAL 问题 (1.3) 现有求解算法相比, 如基于连续时间的投影梯度流求解算法和基于黎曼优化的 Manopt 工具箱求解器, 不动点迭代加速算法在迭代效率上具有较为明显的优势. ...
... ,20 ] 中提出的向量 $\varepsilon$ - 算法 (VEA)、拓扑 $\varepsilon$ - 算法 (TEA) 以及简化版拓扑 $\varepsilon$ - 算法 (STEA) 应用于求解 O-INDSCAL 问题 (1.3). 首先给出求解问题 (1.3) 的不动点迭代框架, 进而利用 VEA, TEA 和 STEA 对不动点迭代原始生成矩阵序列进行收敛加速. 较充分的数值实验表明, 相较于原始不动点迭代生成矩阵序列, 结合 $\varepsilon$ - 算法的不动点迭代加速算法加速效果较为显著. 此外, 与 O-INDSCAL 问题 (1.3) 现有求解算法相比, 如基于连续时间的投影梯度流求解算法和基于黎曼优化的 Manopt 工具箱求解器, 不动点迭代加速算法在迭代效率上具有较为明显的优势. ...
... 提高迭代序列 (标量, 向量, 矩阵或张量序列等) 的收敛速度在科学与工程计算及机器学习等领域具有重要意义[32 39 ] , 也是当今计算数学领域的研究热点课题之一[40 43 ] . 对于收敛较慢的序列, 通常采用合适的加速算法加速其收敛. 通过序列变换调整其生成过程, 将原序列转变为新序列, 在特定条件下, 新序列能够更快收敛至相同的极限. 对于标量数列, 最著名的变换之一是标量 Shanks 变换[15 ] , 它可以通过 Wynn 的标量 $\varepsilon$ - 算法逐步递归实现[16 ] . Wynn[17 ] 同时扩展了该变换, 使其适用于向量序列. 但向量 $\varepsilon$ - 算法的代数理论无法直接从标量 Shanks 变换的规则中推导出来. 为弥补这一不足, Brezinski[18 ] 引入了拓扑 Shanks 变换, 并通过两种拓扑 $\varepsilon$ - 算法 (TEA1 和 TEA2) 将其推广至任意向量空间中的向量序列, 从而实现了该算法的扩展. 近年来, TEA1 和 TEA2 的规则得到了简化, 衍生出两类简化版拓扑 $\varepsilon$ - 算法 (STEA1 和 STEA2)[19 ] , 相关的软件应用见文献[20 ]. 这两种简化版拓扑 $\varepsilon$ - 算法通过减少向量的使用显著降低了存储需求, 并提高了算法的数值稳定性. ...
... 为论文完整性, 本节在文献[17 20 ] 的基础上, 细致阐述 $\varepsilon$ - 加速算法的理论基础, 加速原理及具体实施方案, 进而结合上一节所构建的的不动点迭代框架 (2.12), 设计求解 O-INDSCAL 问题 (1.3) 基于 $\varepsilon$ - 算法的不动点迭代加速算法. ...
... 新的序列$\{T_n\}$ $\{S_n\}$ $\varepsilon$ - 变换、Levin 变换、Shanks 变换、$\rho$ $\theta$ $\eta$ [18 ,44 ] . Shanks 变换假定序列满足如下关系式[20 ,40 ] ...
... $\varepsilon$ - 数表[20 ] ...
... 通过引入新的向量逆, Brezinski[20 ] 给出了计算拓扑Shanks 变换 $\widehat{e}_k(S_n)$ $\widetilde{e}_k(S_n)$ $\varepsilon$ $\varepsilon$ $\varepsilon$ $\{u, \mathbf{y}\} \in E \times E^*$
... Brezinski[20 ] 同时给出了如下重要结果建立了拓扑 Shanks 变换与拓扑 $\varepsilon$ - 算法之间的联系. 对于第一类拓扑 Shanks 变换 $\widehat{e}_k(S_n)$ $\widehat{\varepsilon}^{(n)}_k$
... TEA1 和 TEA2 中奇数下标序列和偶数下标序列计算规则[20 ] ...
... 为了优化两类拓扑$\varepsilon$ - 算法的计算规则, Brezinski[20 ] 针对 TEA1 和 TEA2 分别提出了简化版拓扑 $\varepsilon$ - 算法 (STEA1 和 STEA2), 其通过将 TEA 和 SEA 相结合产生更高效的新算法. 在递归过程中, 两类简化拓扑 $\varepsilon$ - 算法不仅可以大幅度减少对偶积运算, 即在递归过程中代数对偶空间 $E^*$ $\mathbf{y}$ $E$ $\{S_n\}$ $\langle \mathbf{y}, S_n \rangle$
... 由上述计算公式可知, STEA1 和 STEA2 中偶数下标序列的递归只需用到偶数下标序列的信息, 如表 3 所示. 同时注意到, 结合 (3.16) 和 (3.17) 式中第一个等式$\widehat{\varepsilon}^{(n)}_{2k} = e_k(S_n)$ $\widetilde{\varepsilon}^{(n)}_{2k} = e_k(S_n)$ $\widehat{e}_k(S_n)$ $\widetilde{e}_k(S_n)$ $\varepsilon$ - 算法的递归过程中, 均只需存储偶数下标序列的信息, 不需涉及奇数下标序列的存储. 同时 STEA1 和 STEA2 在递归过程中减少了对偶积运算, $E^*$ $\mathbf{y}$ $E$ $\{S_n\}$ $\{\langle \mathbf{y}, S_n \rangle\}$ $\{\langle \mathbf{y}, S_n \rangle\}$ $\varepsilon$ - 算法的收敛性分析和加速理论分析可见文献[20 ]. ...
... STEA1 和 STEA2 中序列计算规则[20 ] ...
... 为了实现 $\varepsilon$ - 算法 (SEA, VEA, TEA 和 STEA) 并构造 $\varepsilon$ - 数表, 最直接的方法是存储所有 $k$ $n$ $\varepsilon$ - 数表的三角形部分. 然而, 这样的方法需要存储整个三角形部分的所有元素, 对于向量序列或矩阵序列而言, 可能会导致较高的存储开销. 为了避免存储整个三角形数表, 一种更高效的方法是逐步计算原始序列的每一项, 并按升序对角线的顺序计算 $\varepsilon$ - 数表[19 ,20 ] . 在生成 $\varepsilon$ - 数表的一个三角形部分并仅存储了其最后一行升序对角线后, 引入初始序列 $\{S_n\}$ $(e_i)$
... 文献[20 ] 中给出了 SEA、VEA、TEA 及 STEA 的基于 MATLAB 的算法工具箱$ {\tt EPSfun}$ $k$ $2k$ $\mathbb{R}^m$ $(x, y)=x^Ty,\ \forall x, y\in \mathbb{R}^m$ . ...
... 算法 4 给出了STEA 的实施过程, 注意STEA 的执行过程由标量部分和向量部分组成. 标量部分继续采用菱形结构, 而向量部分的计算规则调整为三角结构. 在标量部分, 每个新标量项是通过计算序列$\{S_n\}$ $\mathbf{y}$ $k$ 20 ] 中STEA 的标量部分首先利用 SEA 计算所需的标量值, 再通过 STEA 算法处理. 算法 4 给出了STEA2-3 的具体实施过程, 另外三种等价形式可以通过修改算法中的变量$j$
... 注 3.1 SEA、VEA、TEA 及 STEA 在执行过程中, 不涉及任何矩阵分解, 也不需要求解相关子问题, 这是 $\varepsilon$ - 加速算法区别于向量序列多项式外推加速 (如 MPE, MMPE 和 RRE 等) 和 Anderson 加速算法的优势所在. 关于 $E$ $E^*$ $\mathbf{y}$ 19 ,20 ]给出了常用的选取方式. 若原始序列为向量序列$\{S_n\}\subset \mathbb{R}^m$ $\{S_n\}\subset \mathbb{R}^{m\times n}$ $\mathbb{R}^m$ $\mathbb{R}^{m\times n}$
... $ \bullet $ $\varepsilon$ - 算法 (SEA, VEA, TEA 和 STEA) 的核心代码通过 MATLAB 工具箱 ${\tt EPSfun}$ [20 ] 来实现, 具体代码可通过网站 { http://www.netlib.org/numeralgo/ } 下载. 实验中拓扑 $\varepsilon$ - 算法选取 TEA2, 简化 $\varepsilon$ - 拓扑算法选取 STEA2-3. 因完全随机生成 $X_i$ $X_i$ $\mathrm{Error}\leq 10^{-6}$ $X_i$ $\mathrm{Error}\leq 10^{-8}$ $\mathrm{Error}$
Quadratic extrapolation for accelerating convergence of the EM fixed point problem
1
2020
... 本文在文献 [13 ,14 ] 基础上, 进一步考虑将向量序列加速中的经典[15 20 ] 应用于求解 O-INDSCAL 模型问题 (1.3). 值得说明的是, 文献[13 ,14 ]采用的向量序列多项式外推加速算法和 Anderson 加速应用于求解问题 (1.3) 时, 因所涉及的原始序列为矩阵序列, 通常需要用到矩阵拉直和反拉直算子, 即先通过拉直算子将矩阵序列转化为向量序列, 执行向量序列加速, 再通过反拉直算子得到矩阵外推加速迭代更新点. 另一方面, 执行向量序列多项式外推加速算法或 Anderson 加速算法时通常需要涉及矩阵分解求解相应子问题, 如执行 MPE, RRE 或 Anderson 加速时,需通过 QR 分解求解相应最小二乘问题, 执行 MMPE 时需用到列选主元的 LU 分解求解相应最小二乘问题. 与多项式外推加速算法或 Anderson 加速算法相比, $\varepsilon$ - 加速算法的优势在于不需要涉及到矩阵分解求解相应子问题, 同时拓扑 $\varepsilon$ - 算法与简化版拓扑 $\varepsilon$ - 算法可直接适用于矩阵序列或张量序列的收敛加速. $\varepsilon$ - 加速算法, 尤其是简化版拓扑 $\varepsilon$ - 算法, 由于其实现的简易性逐渐得到了数值分析领域研究学者的广泛关注[21 26 ], 同时在实际问题中数值表现优异, 如图像处理和图像复原[27 ] , 矩阵完全化问题[28 ] 和多线性 PageRank 计算[29 ] 等. 本文将文献[19 ,20 ] 中提出的向量 $\varepsilon$ - 算法 (VEA)、拓扑 $\varepsilon$ - 算法 (TEA) 以及简化版拓扑 $\varepsilon$ - 算法 (STEA) 应用于求解 O-INDSCAL 问题 (1.3). 首先给出求解问题 (1.3) 的不动点迭代框架, 进而利用 VEA, TEA 和 STEA 对不动点迭代原始生成矩阵序列进行收敛加速. 较充分的数值实验表明, 相较于原始不动点迭代生成矩阵序列, 结合 $\varepsilon$ - 算法的不动点迭代加速算法加速效果较为显著. 此外, 与 O-INDSCAL 问题 (1.3) 现有求解算法相比, 如基于连续时间的投影梯度流求解算法和基于黎曼优化的 Manopt 工具箱求解器, 不动点迭代加速算法在迭代效率上具有较为明显的优势. ...
Geometrical inverse matrix approximation for least-squares problems and acceleration strategies
0
2020
Shanks and Anderson-type acceleration techniques for systems of nonlinear equations
0
2022
nltgcr: A class of nonlinear acceleration procedures based on conjugate residuals
0
2024
Accelerated numerical solutions for discretized Black-Scholes equations
0
2026
Parameter Choice Rules for Discrete Ill-Posed Problems Based on Extrapolation Methods
1
2025
... 本文在文献 [13 ,14 ] 基础上, 进一步考虑将向量序列加速中的经典[15 20 ] 应用于求解 O-INDSCAL 模型问题 (1.3). 值得说明的是, 文献[13 ,14 ]采用的向量序列多项式外推加速算法和 Anderson 加速应用于求解问题 (1.3) 时, 因所涉及的原始序列为矩阵序列, 通常需要用到矩阵拉直和反拉直算子, 即先通过拉直算子将矩阵序列转化为向量序列, 执行向量序列加速, 再通过反拉直算子得到矩阵外推加速迭代更新点. 另一方面, 执行向量序列多项式外推加速算法或 Anderson 加速算法时通常需要涉及矩阵分解求解相应子问题, 如执行 MPE, RRE 或 Anderson 加速时,需通过 QR 分解求解相应最小二乘问题, 执行 MMPE 时需用到列选主元的 LU 分解求解相应最小二乘问题. 与多项式外推加速算法或 Anderson 加速算法相比, $\varepsilon$ - 加速算法的优势在于不需要涉及到矩阵分解求解相应子问题, 同时拓扑 $\varepsilon$ - 算法与简化版拓扑 $\varepsilon$ - 算法可直接适用于矩阵序列或张量序列的收敛加速. $\varepsilon$ - 加速算法, 尤其是简化版拓扑 $\varepsilon$ - 算法, 由于其实现的简易性逐渐得到了数值分析领域研究学者的广泛关注[21 26 ], 同时在实际问题中数值表现优异, 如图像处理和图像复原[27 ] , 矩阵完全化问题[28 ] 和多线性 PageRank 计算[29 ] 等. 本文将文献[19 ,20 ] 中提出的向量 $\varepsilon$ - 算法 (VEA)、拓扑 $\varepsilon$ - 算法 (TEA) 以及简化版拓扑 $\varepsilon$ - 算法 (STEA) 应用于求解 O-INDSCAL 问题 (1.3). 首先给出求解问题 (1.3) 的不动点迭代框架, 进而利用 VEA, TEA 和 STEA 对不动点迭代原始生成矩阵序列进行收敛加速. 较充分的数值实验表明, 相较于原始不动点迭代生成矩阵序列, 结合 $\varepsilon$ - 算法的不动点迭代加速算法加速效果较为显著. 此外, 与 O-INDSCAL 问题 (1.3) 现有求解算法相比, 如基于连续时间的投影梯度流求解算法和基于黎曼优化的 Manopt 工具箱求解器, 不动点迭代加速算法在迭代效率上具有较为明显的优势. ...
Image reconstruction and restoration using the simplified topological $\varepsilon$ -algorithm
1
2016
... 本文在文献 [13 ,14 ] 基础上, 进一步考虑将向量序列加速中的经典[15 20 ] 应用于求解 O-INDSCAL 模型问题 (1.3). 值得说明的是, 文献[13 ,14 ]采用的向量序列多项式外推加速算法和 Anderson 加速应用于求解问题 (1.3) 时, 因所涉及的原始序列为矩阵序列, 通常需要用到矩阵拉直和反拉直算子, 即先通过拉直算子将矩阵序列转化为向量序列, 执行向量序列加速, 再通过反拉直算子得到矩阵外推加速迭代更新点. 另一方面, 执行向量序列多项式外推加速算法或 Anderson 加速算法时通常需要涉及矩阵分解求解相应子问题, 如执行 MPE, RRE 或 Anderson 加速时,需通过 QR 分解求解相应最小二乘问题, 执行 MMPE 时需用到列选主元的 LU 分解求解相应最小二乘问题. 与多项式外推加速算法或 Anderson 加速算法相比, $\varepsilon$ - 加速算法的优势在于不需要涉及到矩阵分解求解相应子问题, 同时拓扑 $\varepsilon$ - 算法与简化版拓扑 $\varepsilon$ - 算法可直接适用于矩阵序列或张量序列的收敛加速. $\varepsilon$ - 加速算法, 尤其是简化版拓扑 $\varepsilon$ - 算法, 由于其实现的简易性逐渐得到了数值分析领域研究学者的广泛关注[21 26 ], 同时在实际问题中数值表现优异, 如图像处理和图像复原[27 ] , 矩阵完全化问题[28 ] 和多线性 PageRank 计算[29 ] 等. 本文将文献[19 ,20 ] 中提出的向量 $\varepsilon$ - 算法 (VEA)、拓扑 $\varepsilon$ - 算法 (TEA) 以及简化版拓扑 $\varepsilon$ - 算法 (STEA) 应用于求解 O-INDSCAL 问题 (1.3). 首先给出求解问题 (1.3) 的不动点迭代框架, 进而利用 VEA, TEA 和 STEA 对不动点迭代原始生成矩阵序列进行收敛加速. 较充分的数值实验表明, 相较于原始不动点迭代生成矩阵序列, 结合 $\varepsilon$ - 算法的不动点迭代加速算法加速效果较为显著. 此外, 与 O-INDSCAL 问题 (1.3) 现有求解算法相比, 如基于连续时间的投影梯度流求解算法和基于黎曼优化的 Manopt 工具箱求解器, 不动点迭代加速算法在迭代效率上具有较为明显的优势. ...
Matrix completion with $\varepsilon$ -algorithm: In memory of Peter Wynn (1931-2017)
1
2019
... 本文在文献 [13 ,14 ] 基础上, 进一步考虑将向量序列加速中的经典[15 20 ] 应用于求解 O-INDSCAL 模型问题 (1.3). 值得说明的是, 文献[13 ,14 ]采用的向量序列多项式外推加速算法和 Anderson 加速应用于求解问题 (1.3) 时, 因所涉及的原始序列为矩阵序列, 通常需要用到矩阵拉直和反拉直算子, 即先通过拉直算子将矩阵序列转化为向量序列, 执行向量序列加速, 再通过反拉直算子得到矩阵外推加速迭代更新点. 另一方面, 执行向量序列多项式外推加速算法或 Anderson 加速算法时通常需要涉及矩阵分解求解相应子问题, 如执行 MPE, RRE 或 Anderson 加速时,需通过 QR 分解求解相应最小二乘问题, 执行 MMPE 时需用到列选主元的 LU 分解求解相应最小二乘问题. 与多项式外推加速算法或 Anderson 加速算法相比, $\varepsilon$ - 加速算法的优势在于不需要涉及到矩阵分解求解相应子问题, 同时拓扑 $\varepsilon$ - 算法与简化版拓扑 $\varepsilon$ - 算法可直接适用于矩阵序列或张量序列的收敛加速. $\varepsilon$ - 加速算法, 尤其是简化版拓扑 $\varepsilon$ - 算法, 由于其实现的简易性逐渐得到了数值分析领域研究学者的广泛关注[21 26 ], 同时在实际问题中数值表现优异, 如图像处理和图像复原[27 ] , 矩阵完全化问题[28 ] 和多线性 PageRank 计算[29 ] 等. 本文将文献[19 ,20 ] 中提出的向量 $\varepsilon$ - 算法 (VEA)、拓扑 $\varepsilon$ - 算法 (TEA) 以及简化版拓扑 $\varepsilon$ - 算法 (STEA) 应用于求解 O-INDSCAL 问题 (1.3). 首先给出求解问题 (1.3) 的不动点迭代框架, 进而利用 VEA, TEA 和 STEA 对不动点迭代原始生成矩阵序列进行收敛加速. 较充分的数值实验表明, 相较于原始不动点迭代生成矩阵序列, 结合 $\varepsilon$ - 算法的不动点迭代加速算法加速效果较为显著. 此外, 与 O-INDSCAL 问题 (1.3) 现有求解算法相比, 如基于连续时间的投影梯度流求解算法和基于黎曼优化的 Manopt 工具箱求解器, 不动点迭代加速算法在迭代效率上具有较为明显的优势. ...
Extrapolation methods for fixed-point multilinear PageRank computations
1
2020
... 本文在文献 [13 ,14 ] 基础上, 进一步考虑将向量序列加速中的经典[15 20 ] 应用于求解 O-INDSCAL 模型问题 (1.3). 值得说明的是, 文献[13 ,14 ]采用的向量序列多项式外推加速算法和 Anderson 加速应用于求解问题 (1.3) 时, 因所涉及的原始序列为矩阵序列, 通常需要用到矩阵拉直和反拉直算子, 即先通过拉直算子将矩阵序列转化为向量序列, 执行向量序列加速, 再通过反拉直算子得到矩阵外推加速迭代更新点. 另一方面, 执行向量序列多项式外推加速算法或 Anderson 加速算法时通常需要涉及矩阵分解求解相应子问题, 如执行 MPE, RRE 或 Anderson 加速时,需通过 QR 分解求解相应最小二乘问题, 执行 MMPE 时需用到列选主元的 LU 分解求解相应最小二乘问题. 与多项式外推加速算法或 Anderson 加速算法相比, $\varepsilon$ - 加速算法的优势在于不需要涉及到矩阵分解求解相应子问题, 同时拓扑 $\varepsilon$ - 算法与简化版拓扑 $\varepsilon$ - 算法可直接适用于矩阵序列或张量序列的收敛加速. $\varepsilon$ - 加速算法, 尤其是简化版拓扑 $\varepsilon$ - 算法, 由于其实现的简易性逐渐得到了数值分析领域研究学者的广泛关注[21 26 ], 同时在实际问题中数值表现优异, 如图像处理和图像复原[27 ] , 矩阵完全化问题[28 ] 和多线性 PageRank 计算[29 ] 等. 本文将文献[19 ,20 ] 中提出的向量 $\varepsilon$ - 算法 (VEA)、拓扑 $\varepsilon$ - 算法 (TEA) 以及简化版拓扑 $\varepsilon$ - 算法 (STEA) 应用于求解 O-INDSCAL 问题 (1.3). 首先给出求解问题 (1.3) 的不动点迭代框架, 进而利用 VEA, TEA 和 STEA 对不动点迭代原始生成矩阵序列进行收敛加速. 较充分的数值实验表明, 相较于原始不动点迭代生成矩阵序列, 结合 $\varepsilon$ - 算法的不动点迭代加速算法加速效果较为显著. 此外, 与 O-INDSCAL 问题 (1.3) 现有求解算法相比, 如基于连续时间的投影梯度流求解算法和基于黎曼优化的 Manopt 工具箱求解器, 不动点迭代加速算法在迭代效率上具有较为明显的优势. ...
A simple general procedure for orthogonal rotation
1
2001
... 显然无法直接从 (2.10) 式中获得 $Q$ $Q$ [13 ,14 ] : (1) 利用当前迭代步$Q^{(j)}$ $G^{(j)}:=\sum_{i=1}^mX_i Q^{(j)}{D}_i^{(j+1)}$ $Q^TQ=I_p$ $(I_n-QQ^T)G^{(j)}=0$ $ Q^{(j+1)}$ . 记$G^{(j)}=U\triangle V^T$ $G^{(j)}\in \mathbb{R}^{n\times p}$ $U\in\mathbb{R}^{n\times p}$ $V\in\mathbb{R}^{p\times p}$ 31 ], 方程$(I_n-QQ^T)G^{(j)}$ $=0$ $Q^TQ=I_p$ $Q$
Fast solvers for discretized Navier-Stokes problems using vector extrapolation
1
2014
... 提高迭代序列 (标量, 向量, 矩阵或张量序列等) 的收敛速度在科学与工程计算及机器学习等领域具有重要意义[32 39 ] , 也是当今计算数学领域的研究热点课题之一[40 43 ] . 对于收敛较慢的序列, 通常采用合适的加速算法加速其收敛. 通过序列变换调整其生成过程, 将原序列转变为新序列, 在特定条件下, 新序列能够更快收敛至相同的极限. 对于标量数列, 最著名的变换之一是标量 Shanks 变换[15 ] , 它可以通过 Wynn 的标量 $\varepsilon$ - 算法逐步递归实现[16 ] . Wynn[17 ] 同时扩展了该变换, 使其适用于向量序列. 但向量 $\varepsilon$ - 算法的代数理论无法直接从标量 Shanks 变换的规则中推导出来. 为弥补这一不足, Brezinski[18 ] 引入了拓扑 Shanks 变换, 并通过两种拓扑 $\varepsilon$ - 算法 (TEA1 和 TEA2) 将其推广至任意向量空间中的向量序列, 从而实现了该算法的扩展. 近年来, TEA1 和 TEA2 的规则得到了简化, 衍生出两类简化版拓扑 $\varepsilon$ - 算法 (STEA1 和 STEA2)[19 ] , 相关的软件应用见文献[20 ]. 这两种简化版拓扑 $\varepsilon$ - 算法通过减少向量的使用显著降低了存储需求, 并提高了算法的数值稳定性. ...
Anderson acceleration of the alternating projections method for computing the nearest correlation matrix
0
2016
Anderson acceleration and application to the three-temperature energy equations
0
2017
Vector extrapolation methods for accelerating iterative reconstruction methods in limited-data photoacoustic tomography
0
2018
Anderson-accelerated convergence of Picard iterations for incompressible Navier-Stokes equations
0
2019
Convergence acceleration of iterative sequences for equilibrium chemistry computations
0
2021
Anderson accelerated fixed-point iteration for multilinear PageRank
0
2023
Extrapolation methods for multilinear PageRank
1
2025
... 提高迭代序列 (标量, 向量, 矩阵或张量序列等) 的收敛速度在科学与工程计算及机器学习等领域具有重要意义[32 39 ] , 也是当今计算数学领域的研究热点课题之一[40 43 ] . 对于收敛较慢的序列, 通常采用合适的加速算法加速其收敛. 通过序列变换调整其生成过程, 将原序列转变为新序列, 在特定条件下, 新序列能够更快收敛至相同的极限. 对于标量数列, 最著名的变换之一是标量 Shanks 变换[15 ] , 它可以通过 Wynn 的标量 $\varepsilon$ - 算法逐步递归实现[16 ] . Wynn[17 ] 同时扩展了该变换, 使其适用于向量序列. 但向量 $\varepsilon$ - 算法的代数理论无法直接从标量 Shanks 变换的规则中推导出来. 为弥补这一不足, Brezinski[18 ] 引入了拓扑 Shanks 变换, 并通过两种拓扑 $\varepsilon$ - 算法 (TEA1 和 TEA2) 将其推广至任意向量空间中的向量序列, 从而实现了该算法的扩展. 近年来, TEA1 和 TEA2 的规则得到了简化, 衍生出两类简化版拓扑 $\varepsilon$ - 算法 (STEA1 和 STEA2)[19 ] , 相关的软件应用见文献[20 ]. 这两种简化版拓扑 $\varepsilon$ - 算法通过减少向量的使用显著降低了存储需求, 并提高了算法的数值稳定性. ...
Shanks sequence transformations and Anderson acceleration
2
2018
... 提高迭代序列 (标量, 向量, 矩阵或张量序列等) 的收敛速度在科学与工程计算及机器学习等领域具有重要意义[32 39 ] , 也是当今计算数学领域的研究热点课题之一[40 43 ] . 对于收敛较慢的序列, 通常采用合适的加速算法加速其收敛. 通过序列变换调整其生成过程, 将原序列转变为新序列, 在特定条件下, 新序列能够更快收敛至相同的极限. 对于标量数列, 最著名的变换之一是标量 Shanks 变换[15 ] , 它可以通过 Wynn 的标量 $\varepsilon$ - 算法逐步递归实现[16 ] . Wynn[17 ] 同时扩展了该变换, 使其适用于向量序列. 但向量 $\varepsilon$ - 算法的代数理论无法直接从标量 Shanks 变换的规则中推导出来. 为弥补这一不足, Brezinski[18 ] 引入了拓扑 Shanks 变换, 并通过两种拓扑 $\varepsilon$ - 算法 (TEA1 和 TEA2) 将其推广至任意向量空间中的向量序列, 从而实现了该算法的扩展. 近年来, TEA1 和 TEA2 的规则得到了简化, 衍生出两类简化版拓扑 $\varepsilon$ - 算法 (STEA1 和 STEA2)[19 ] , 相关的软件应用见文献[20 ]. 这两种简化版拓扑 $\varepsilon$ - 算法通过减少向量的使用显著降低了存储需求, 并提高了算法的数值稳定性. ...
... 新的序列$\{T_n\}$ $\{S_n\}$ $\varepsilon$ - 变换、Levin 变换、Shanks 变换、$\rho$ $\theta$ $\eta$ [18 ,44 ] . Shanks 变换假定序列满足如下关系式[20 ,40 ] ...
Convergence acceleration during the 20th century
0
2000
Acceleration methods
0
2021
Acceleration methods for fixed point iterations
1
2025
... 提高迭代序列 (标量, 向量, 矩阵或张量序列等) 的收敛速度在科学与工程计算及机器学习等领域具有重要意义[32 39 ] , 也是当今计算数学领域的研究热点课题之一[40 43 ] . 对于收敛较慢的序列, 通常采用合适的加速算法加速其收敛. 通过序列变换调整其生成过程, 将原序列转变为新序列, 在特定条件下, 新序列能够更快收敛至相同的极限. 对于标量数列, 最著名的变换之一是标量 Shanks 变换[15 ] , 它可以通过 Wynn 的标量 $\varepsilon$ - 算法逐步递归实现[16 ] . Wynn[17 ] 同时扩展了该变换, 使其适用于向量序列. 但向量 $\varepsilon$ - 算法的代数理论无法直接从标量 Shanks 变换的规则中推导出来. 为弥补这一不足, Brezinski[18 ] 引入了拓扑 Shanks 变换, 并通过两种拓扑 $\varepsilon$ - 算法 (TEA1 和 TEA2) 将其推广至任意向量空间中的向量序列, 从而实现了该算法的扩展. 近年来, TEA1 和 TEA2 的规则得到了简化, 衍生出两类简化版拓扑 $\varepsilon$ - 算法 (STEA1 和 STEA2)[19 ] , 相关的软件应用见文献[20 ]. 这两种简化版拓扑 $\varepsilon$ - 算法通过减少向量的使用显著降低了存储需求, 并提高了算法的数值稳定性. ...
The genesis and early developments of Aitken's process, Shanks' transformation, the $\varepsilon$ -algorithm, and related fixed point methods
1
2019
... 新的序列$\{T_n\}$ $\{S_n\}$ $\varepsilon$ - 变换、Levin 变换、Shanks 变换、$\rho$ $\theta$ $\eta$ [18 ,44 ] . Shanks 变换假定序列满足如下关系式[20 ,40 ] ...
Vector Extrapolation Methods with Applications
2
2017
... 考虑到不动点迭代(2.12) 生成的原始序列为矩阵序列, 同时$\mathcal{H} _{\mathrm{INDSCAL}}: \mathbb{R}^{n\times p}\rightarrow \mathbb{R}^{n\times p}$ [45 ] 采用循环的方式执行 $\varepsilon$ - 加速算法. 另一方面, 在加速算法的具体执行中, 为达到更好的加速效果, 通常采用延迟启动的方式, 即基本不动点迭代 (2.12) 先迭代若干固定次数或矩阵序列$\{(Q^ {(j)}, D_1^{(j)}, \cdots, D_m^{(j)})\}$ $\varepsilon$ - 算法的不动点迭代加速算法的具体描述见算法 5. ...
... 从表 6 中可以看出, 对于原始数据 $X_i$ ${\tt FPI-MPE}$ ${\tt FPI-RRE}$ ${\tt FPI-MMPE}$ ) 相比, 达到相同的迭代终止精度, $\varepsilon$ - 加速算法 (${\tt FPI-VEA}$ ${\tt FPI-TEA}$ ${\tt FPI-STEA}$ ) 通常需要更多的迭代步和迭代时间, 这是因为对于相同的加速窗口宽度 $k$ $\varepsilon$ - 加速算法需要 $2k+1$ ${\tt FPI-MPE}$ ${\tt FPI-RRE}$ ${\tt FPI-MMPE}$ $k+1$ [14 ,45 ] . 但值得说明的是 ${\tt FPI-TEA}$ ${\tt FPI-STEA}$ $\varepsilon$ - 算法的不动点迭代加速算法与结合多项式外推加速和 Anderson 加速的不动点迭代加速算法相比具有可比较的加速效果. ...
2
2008
... 注 3.3 对于算法 5 的终止标准, 结合问题 (1.3) 的一阶最优性条件[12 ] , 同时注意到$\mathcal{O}(n,p)$ $\mathbb{R} ^{n\times p}$ [46 ] 以及$\Omega_{+}(p)$
... 其中$\epsilon$ $\mathcal{P}_{{\mathbf{T}_{Q}}\mathcal{O}(n,p)}$ $\mathcal{O}(n,p)$ $Q$ ${\mathbf{T}_{Q}\mathcal{O}(n,p)}$ 2 ,46 ], $\forall M\in \mathbb{R}^{n\times p}$
Manopt, a Matlab toolbox for optimization on manifolds
2
2014
... 本节给出数值实验说明结合 $\varepsilon$ - 算法的不动点迭代加速算法应用于求解 O-INDSCAL 问题 (1.3) 的数值效果. 首先给出结合 $\varepsilon$ - 算法的不动点迭代加速算法与原始不动点迭代的数值比较, 进而给出结合 $\varepsilon$ - 算法的不动点迭代加速算法与文献[14 ] 提出的结合向量序列多项式外推加速的不动点迭代加速算法和结合 Anderson 加速的不动点迭代加速算法的数值比较. 同时给出加速算法与问题 (1.3) 求解已有的基于黎曼优化的 Manopt 工具箱求解器[2 ,47 ] 和基于连续时间的投影梯度流算法[5 ,6 ] 的数值比较. 所有的数值结果均通过 Matlab(R2022b), $\text{Intel}^{\circledR}$
... 问题 (1.3) 设计了基于黎曼优化工具箱 Manopt[47 ] 的算法框架. 本小节给出 ${\tt FPI-VEA}$ ${\tt FPI-TEA}$ ${\tt FPI-STEA}$
A trust-region approach for iteration solution of the direct fitting metric MDS
1
2025
... 其中 $\Omega(p)$ $p$ 14 ,第 4.3 小节], 更多关于基于黎曼优化求解 MDS 中各类矩阵优化模型的文献可参考文献 [48 50 ]. 基于一阶最优性条件, 利用黎曼优化算法求解问题 (4.2) 的终止标准均取为 ...
An efficient algorithm for fitting the three-way GIPSCAL problem with missing values from asymmetric multidimensional scaling
0
2025
A Riemannian inexact Newton method for solving the orthogonal INDSCAL problem in multidimensional scaling
1
2025
... 其中 $\Omega(p)$ $p$ 14 ,第 4.3 小节], 更多关于基于黎曼优化求解 MDS 中各类矩阵优化模型的文献可参考文献 [48 50 ]. 基于一阶最优性条件, 利用黎曼优化算法求解问题 (4.2) 的终止标准均取为 ...